No meu último benchmark comercial de LLMs, eu já tinha avisado que provavelmente pararia de atualizar aquele ranking. Eu continuo achando que não vale mais a pena ficar correndo atrás de cada lançamento só para medir qualidade pura.
Pelo menos em qualidade e performance de código, o jogo perdeu a graça. Pouco me importa se a Anthropic acabou de soltar o Claude Fable 5.2 ou se a OpenAI soltou o GPT-6.2 Astra: na prática, nenhum deles vai mudar o meu dia a dia.
Claro que em nichos muito específicos e problemas cabeludos de matemática ou algoritmos raros eles devem ter melhorado alguma coisa. No trabalho cotidiano de engenharia de software, o resultado final é o mesmo.
Pior: toda vez que um laboratório anuncia um modelo novo dessa safra, a minha sensação é que eles só ficaram mais caros por token ou passaram a queimar muito mais tokens do que precisavam para entregar a mesma coisa. Foi exatamente por isso que resolvi fazer o Benchmark v5 no llm-coding-benchmark, mudando a régua para o que realmente dói no bolso: custo, velocidade e economia de prompt caching.
O experimento: todos podem terminar, mas a que preço?
Para o v5, eu revisitei o desafio de criar do zero uma aplicação web completa em Ruby on Rails com chat usando RubyLLM (o mesmo escopo de 14 objetivos da v2: Tailwind, Hotwire/Stimulus/Turbo Streams, streaming real, persistência segura sob WEB_CONCURRENCY=2, tools de server_time e calculator, auto-título com structured output, controle de orçamento de tokens, Minitest com SimpleCov, RuboCop, Brakeman, Dockerfile e Docker Compose).
Cada modelo rodou no seu harness CLI (codex, claude, agy, opencode, qwen, grok, muse) em duas fases: Fase 1 de construção e Fase 2 de validação local e em Docker. Todos os custos foram calculados sobre a tabela oficial de preços de API verificada em 19 de novembro de 2026, separando exatamente cinco baldes de tokens (input_uncached, cache_read, cache_write, output e reasoning).
Como o meu ponto central é que os modelos convergiram e conseguem resolver os mesmos problemas gerais, o runner do v5 foi desenhado para permitir até 2 empurrões padronizados (nudges) caso algum modelo travasse nos testes, no boot ou no Docker. Eu não considero isso injusto. A ideia era justamente dar a todos a chance de entregar o aplicativo funcionando e somar o custo e o tempo de qualquer empurrão na conta final.
A surpresa do experimento: nenhum dos 16 modelos que completaram a rodada precisou de um único empurrão. Todos os 16 passaram no gate de qualidade de primeira, com zero nudges.
O único modelo da lista que ficou fora do ranking foi o Muse Wonder 1.0, da Meta, por um bloqueio de infraestrutura: a assinatura estourou 103% da janela de cota com erro HTTP 429 depois de apenas 12 chamadas. Eu já tinha passado exatamente por esse mesmo problema no benchmark v4, quando cotas e travamentos fizeram 126 minutos úteis se arrastarem por quase 15 dias.
Ele é de longe a opção mais cara para a cota mais apertada do mercado, a ponto de nem me deixar terminar um benchmark simples. O modelo pode até ser maravilhoso, mas isso simplesmente não importa se você mal consegue usá-lo; eu não tenho como recomendar.
Os outros 16 modelos entregaram a mesma aplicação Rails funcionando, testada, lintada e rodando no Docker. A diferença ficou inteiramente em quanto tempo levaram e quanto custaram.
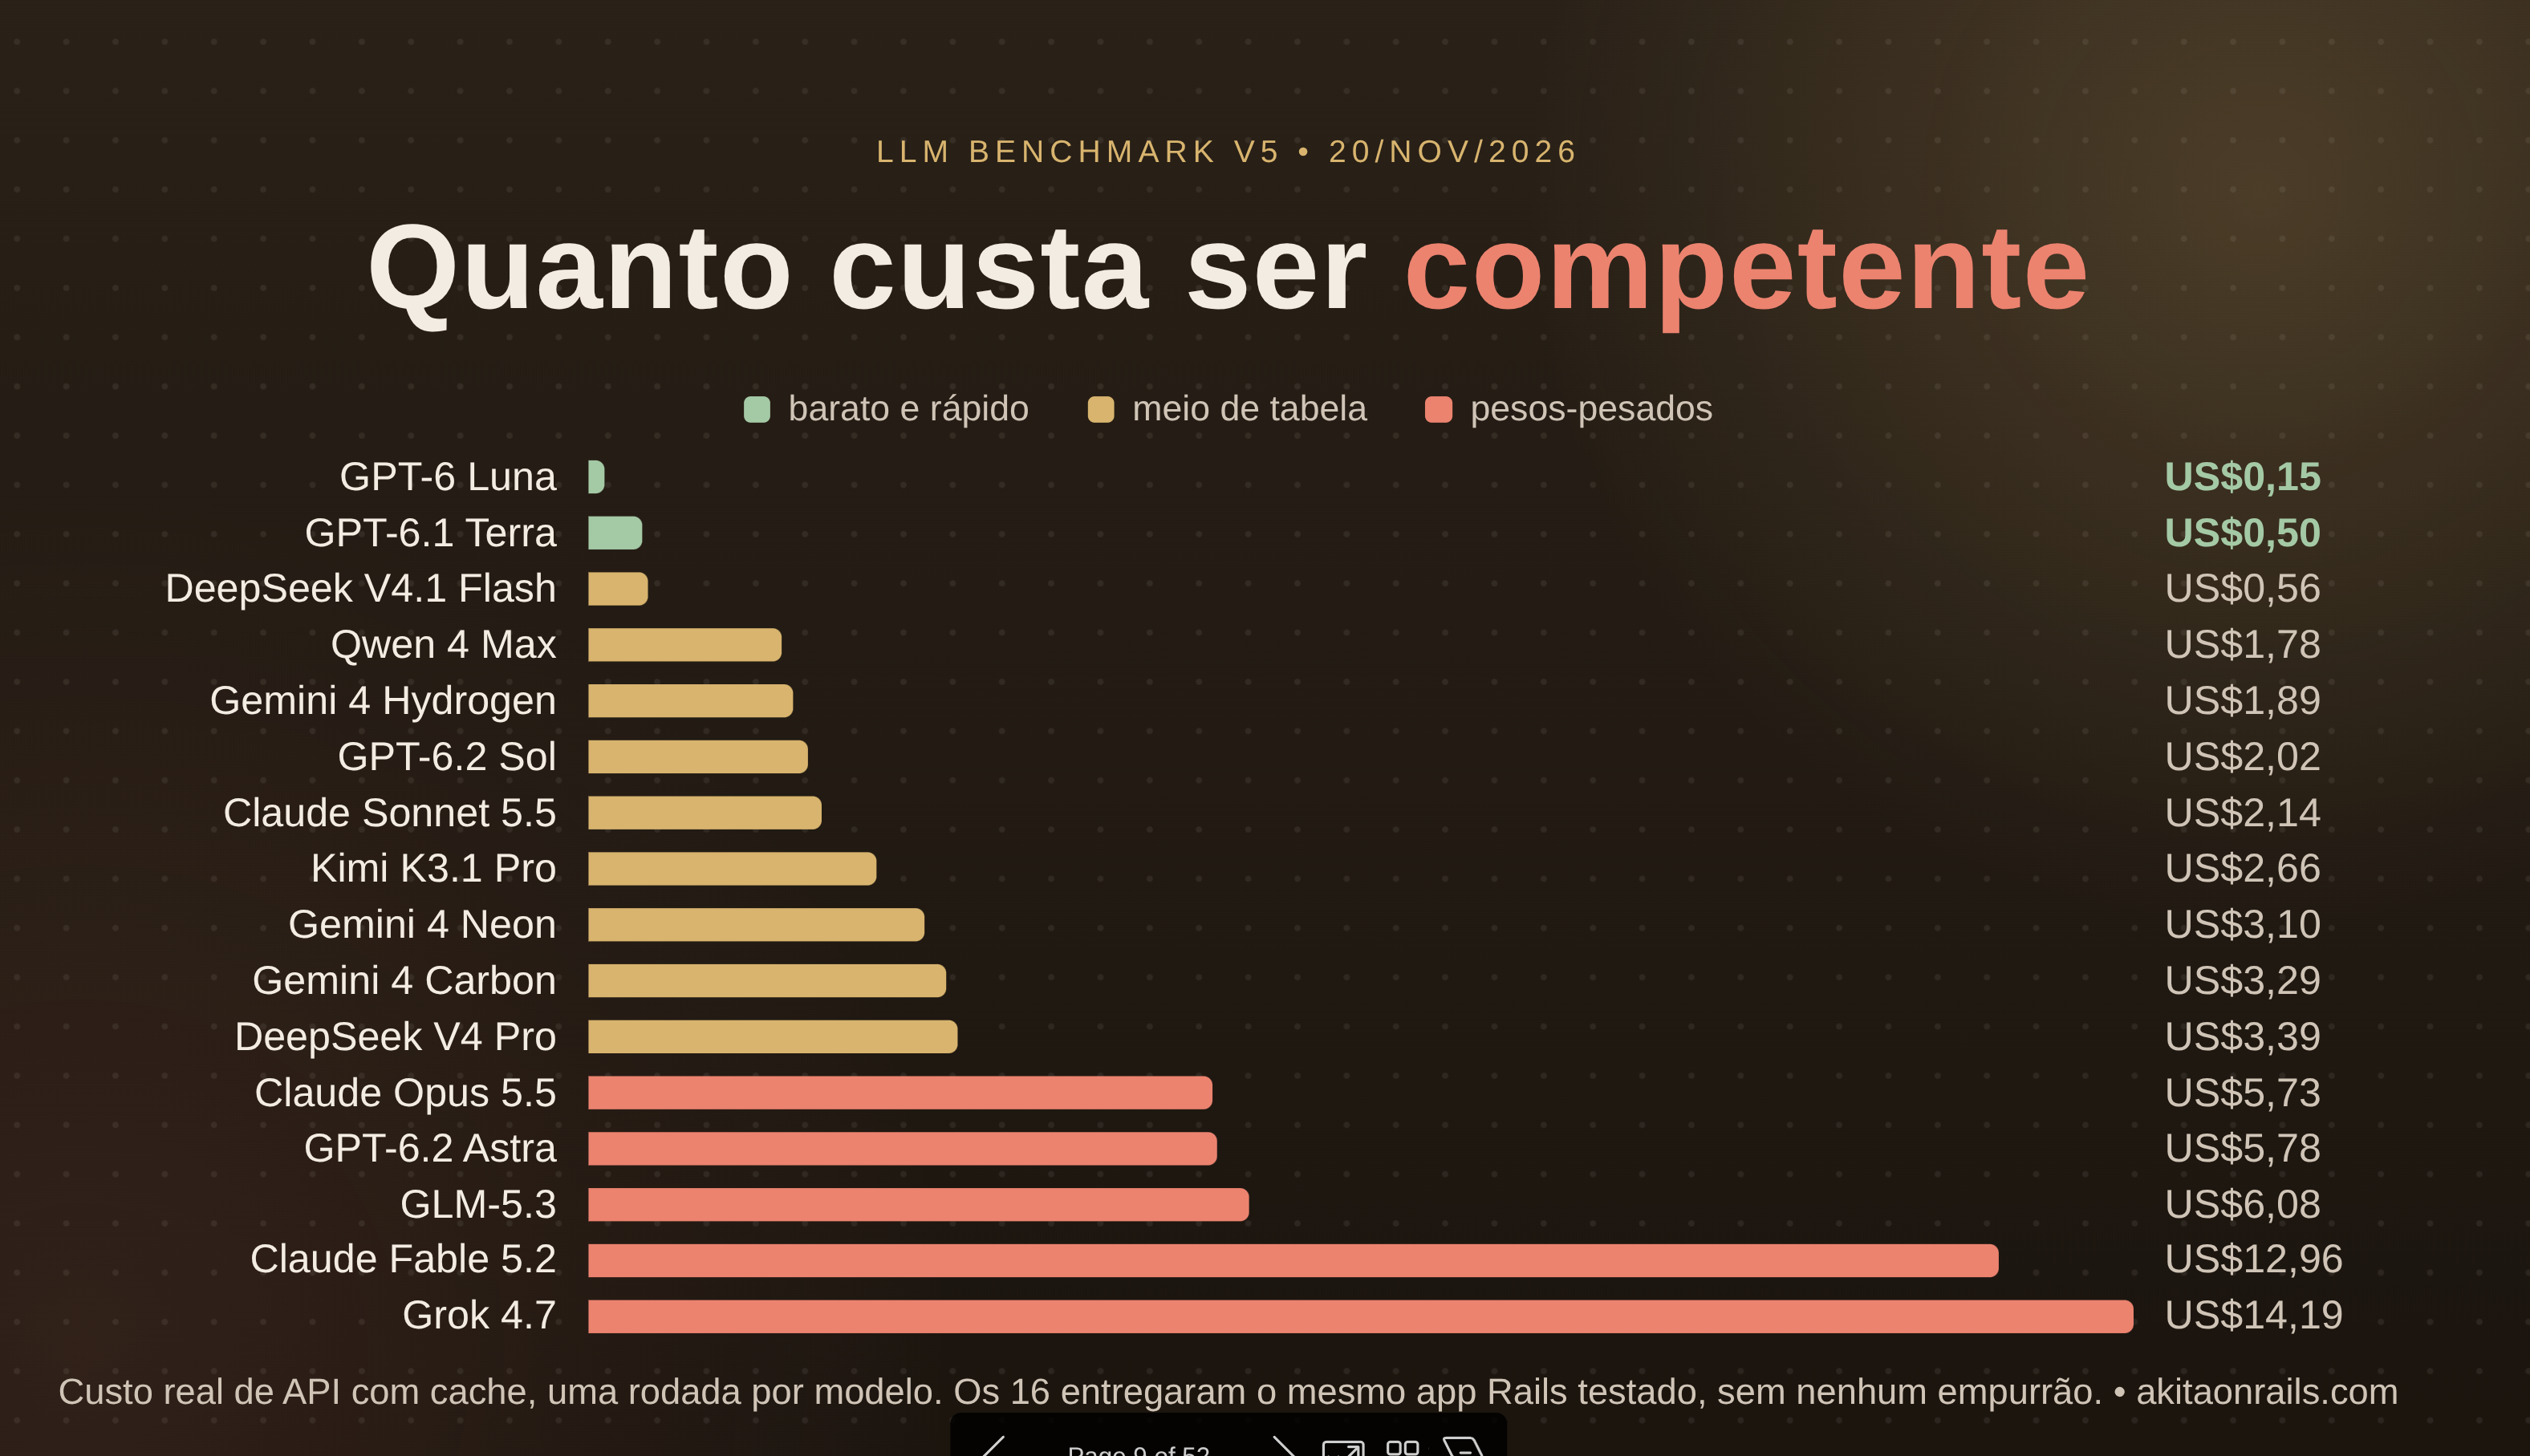
O ranking do Benchmark v5 (ordenado por custo real de API)
A tabela abaixo ordena os 16 modelos aprovados pelo custo real equivalente em API oficial (com cache de prompt ativo), comparando também quanto a mesma execução custaria sem cache, a economia gerada pelo cache, a taxa de acerto (cache hit), o tempo total de relógio e o volume de tokens movimentado:
| Rank | Modelo | Família | Harness | Nudges | Tempo | Custo Real | Sem Cache | Economia Cache | Cache Hit | Tokens Totais |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | GPT-6 Luna | OpenAI | codex | 0 | 19,4m | US$ 0,15 | US$ 1,03 | -85,6% | 97,8% | 10,10M |
| 2 | GPT-6.1 Terra | OpenAI | codex | 0 | 7,4m | US$ 0,50 | US$ 4,77 | -89,5% | 96,8% | 4,67M |
| 3 | DeepSeek V4.1 Flash | DeepSeek | opencode | 0 | 29,2m | US$ 0,56¹ | US$ 9,87 | -94,3% | 98,4% | 32,35M |
| 4 | Qwen 4 Max | Alibaba | qwen | 0 | 43,8m | US$ 1,78 | US$ 18,22 | -90,2% | 97,5% | 11,93M |
| 5 | Gemini 4 Hydrogen | agy | 0 | 16,2m | US$ 1,89 | US$ 12,89 | -85,3% | 95,4% | 8,19M | |
| 6 | GPT-6.2 Sol | OpenAI | codex | 0 | 25,3m | US$ 2,02 | US$ 17,20 | -88,2% | 96,7% | 8,33M |
| 7 | Claude Sonnet 5.5 | Anthropic | claude | 0 | 15,7m | US$ 2,14 | US$ 11,50 | -81,4% | 96,5% | 5,39M |
| 8 | Kimi K3.1 Pro | Moonshot | opencode | 0 | 16,0m | US$ 2,66² | US$ 14,23 | -81,3% | 95,6% | 6,80M |
| 9 | Gemini 4 Neon | agy | 0 | 24,1m | US$ 3,10 | US$ 16,01 | -80,6% | 93,9% | 4,92M | |
| 10 | Gemini 4 Carbon | agy | 0 | 39,1m | US$ 3,29³ | US$ 21,32 | -84,6% | 95,4% | 10,09M | |
| 11 | DeepSeek V4 Pro | DeepSeek | opencode | 0 | 35,2m | US$ 3,39⁴ | US$ 49,25 | -93,1% | 98,3% | 36,81M |
| 12 | Claude Opus 5.5 | Anthropic | claude | 0 | 19,7m | US$ 5,73⁵ | US$ 40,06 | -85,7% | 97,7% | 9,58M |
| 13 | GPT-6.2 Astra | OpenAI | codex | 0 | 15,9m | US$ 5,78 | US$ 58,92 | -90,2% | 97,6% | 7,20M |
| 14 | GLM-5.3 | Z.ai | opencode | 0 | 28,5m | US$ 6,08⁶ | US$ 29,44 | -79,4% | 99,1% | 20,80M |
| 15 | Claude Fable 5.2 | Anthropic | claude | 0 | 35,0m | US$ 12,96 | US$ 82,14 | -84,2% | 96,9% | 9,63M |
| 16 | Grok 4.7 | xAI | grok | 0 | 87,4m | US$ 14,19⁷ | US$ 46,09 | -69,2% | 95,0% | 22,60M |
Notas de rodapé da tabela:
- ¹ DeepSeek V4.1 Flash: US$ 0,56 no horário de pico oficial; cai para US$ 0,28 no off-peak e US$ 0,43 via OpenRouter.
- ² Kimi K3.1 Pro: US$ 2,66 na API oficial da Moonshot; US$ 1,92 via OpenRouter.
- ³ Gemini 4 Carbon: US$ 3,29 no preço promocional de lançamento da Google (US$ 2/US$ 10 até 30 de novembro de 2026); a partir de 1º de dezembro dobra para US$ 6,58.
- ⁴ DeepSeek V4 Pro: US$ 3,39 no pico oficial (US$ 1,69 off-peak); via OpenRouter a mesma execução salta para US$ 10,59.
- ⁵ Claude Opus 5.5: passou nos 135 testes (99,77% de cobertura), RuboCop, Brakeman e Docker logo na Fase 2 sem precisar editar uma linha; um bug inicial no runner sem Redis efêmero chegou a disparar dois nudges falsos (+US$ 1,69), mas a tabela mostra o custo real das Fases 1 e 2.
- ⁶ GLM-5.3: US$ 6,08 na API oficial da Z.ai; via provedores com desconto no OpenRouter cai para US$ 1,58.
- ⁷ Grok 4.7: a Fase 2 encerrou por timeout de espera em background depois de registrar todos os 87 eventos de uso (US$ 9,51 da Fase 1 + US$ 4,68 recuperados da Fase 2).
A conta real por trás dos números: prompt caching e verbosidade
O primeiro número que salta aos olhos nessa tabela é a distância entre o primeiro e o último lugar: 95 vezes de diferença de preço (US$ 0,15 contra US$ 14,19) para entregar a mesma aplicação Rails aprovada nos mesmos testes. Em tempo de relógio, a variação foi de quase 12 vezes (7,4 minutos no GPT-6.1 Terra contra 87,4 minutos no Grok 4.7).
Mas o achado mais importante do v5 é que olhar só o preço de tabela por milhão de tokens engana completamente. Em programação agentic, de 94% a 99% de todos os tokens de entrada são leituras de cache (cache reads). Sem prompt caching, uma única app Rails custaria entre US$ 11,50 e US$ 82,14 nos modelos maiores. O cache derrubou as contas entre 69% e 94%.
Três efeitos escondidos explicam por que a ordem final surpreendeu tanta gente:
- No Claude Code com TTL de 1 hora (que cobra 2x o preço base de entrada na escrita do cache), só o cache write representou entre 30% e 37% da fatura inteira. No Claude Fable 5.2, US$ 4,78 dos US$ 12,96 foram embora só gravando cache; no Opus 5.5 foram US$ 1,72 de US$ 5,73; no Sonnet 5.5, US$ 0,73 de US$ 2,14.
- GPT-6.2 Astra e Claude Fable 5.2 têm exatamente o mesmo preço de tabela (US$ 8 por milhão de entrada, US$ 40 por milhão de saída). Ainda assim, o Astra custou menos da metade (US$ 5,78 contra US$ 12,96) e terminou em menos da metade do tempo (15,9 minutos contra 35 minutos), porque gerou quatro vezes menos tokens de saída (40 mil contra 159 mil) e zerou a taxa de cache write no Codex.
- O Grok 4.7 tem um preço de entrada simpático (US$ 2/M), mas dá apenas 75% de desconto na leitura de cache (US$ 0,50/M) e ainda dobra a tarifa acima de 200 mil tokens de contexto. Como queimou 21 milhões de tokens em cache read, pagou US$ 10,63 só lendo cache e virou o modelo mais caro do benchmark inteiro, superando até o Fable 5.2.
Analisando os grupos de modelos
Os ultrabaratos na fronteira de Pareto: GPT-6 Luna e GPT-6.1 Terra
Se cruzarmos apenas preço x velocidade, existem só dois modelos na fronteira estrita de Pareto do benchmark inteiro: GPT-6 Luna (US$ 0,15 em 19,4 minutos) e GPT-6.1 Terra (US$ 0,50 em 7,4 minutos). Todos os outros 14 modelos custaram mais caro e demoraram mais tempo do que o Terra nesta tarefa.
Como era de se esperar, modelos menores são muito mais baratos. O que surpreendeu foi ver tanto o Luna quanto o Terra passarem no gate completo sem precisar de nenhum empurrão.
Agora, vale olhar para como eles passaram. Inspecionando os projetos gerados no disco, fica clara a diferença de profundidade: o GPT-6 Luna entregou uma app enxuta com 4 arquivos de teste (143 linhas) e cerca de 320 linhas de código em app/. O Terra foi ainda mais seco: 4 arquivos de teste (190 linhas) e 260 linhas em app/. Tudo válido, tudo passando no RuboCop, no Brakeman e no Docker, sem alucinar APIs do RubyLLM.
Compare isso com o que modelos maiores produziram no mesmo desafio: o Claude Sonnet 5.5 escreveu 12 arquivos de teste (705 linhas), o Gemini 4 Neon escreveu 14 arquivos (1.084 linhas), o Opus 5.5 escreveu 18 arquivos (1.097 linhas) e o Fable 5.2 escreveu 21 arquivos (1.640 linhas). O Luna e o Terra resolvem o mínimo necessário para cumprir a especificação sem cerimônia; modelos intermediários e de fronteira tendem a modularizar mais e cobrir mais casos de borda.
O meio da tabela: onde mora o custo-benefício real (US$ 1,78 a US$ 3,39)
Entre US$ 1,78 e US$ 3,39 temos o pelotão mais interessante do mercado hoje: Qwen 4 Max (US$ 1,78), Gemini 4 Hydrogen (US$ 1,89), GPT-6.2 Sol (US$ 2,02), Claude Sonnet 5.5 (US$ 2,14), Kimi K3.1 Pro (US$ 2,66), Gemini 4 Neon (US$ 3,10) e Gemini 4 Carbon (US$ 3,29 no preço promocional, mas lembrando que sobe para US$ 6,58 em 1º de dezembro).
Olha o agrupamento de tempo ali: Sonnet 5.5 (15,7m), Kimi K3.1 Pro (16,0m) e Gemini 4 Hydrogen (16,2m) entregam o projeto completo em cerca de 16 minutos por volta de dois dólares. Você recebe suítes de teste bem mais completas (de 9 a 17 arquivos de teste) pagando uma fração do preço de um modelo de topo.
Os pesos pesados de fronteira (US$ 5,73 a US$ 14,19)
No topo da conta ficaram Claude Opus 5.5 (US$ 5,73 em 19,7m) e GPT-6.2 Astra (US$ 5,78 em 15,9m), praticamente empatados no preço. Acima deles, o Claude Fable 5.2 (US$ 12,96 em 35m) custa mais do que o dobro do Opus e do Astra para entregar o mesmo aplicativo aprovado, e o Grok 4.7 (US$ 14,19 em quase uma hora e meia) fica completamente fora de proporção para tarefas desse porte.
E se você usa assinatura mensal em vez de API direta, essa conta ajuda a saber quando o plano se paga:
| Plano | Mensalidade | Modelo | Custo API / Run | Ponto de equilíbrio |
|---|---|---|---|---|
| Claude Max 20x | US$ 200 | Claude Fable 5.2 | US$ 12,96 | ~15 execuções/mês |
| Claude Max 20x | US$ 200 | Claude Opus 5.5 | US$ 5,73 | ~35 execuções/mês |
| Claude Pro | US$ 20 | Claude Sonnet 5.5 | US$ 2,14 | ~9 execuções/mês |
| ChatGPT Pro 20x | US$ 200 | GPT-6.2 Astra | US$ 5,78 | ~35 execuções/mês |
| ChatGPT Plus | US$ 20 | GPT-6.2 Sol | US$ 2,02 | ~10 execuções/mês |
| ChatGPT Plus | US$ 20 | GPT-6.1 Terra | US$ 0,50 | ~40 execuções/mês |
| Google AI Pro | US$ 20 | Gemini 4 Neon / Carbon | US$ 3,10 a US$ 3,29 | ~6 execuções/mês |
| Z.ai Coding Lite | US$ 18 | GLM-5.3 | US$ 6,08 oficial (US$ 1,58 OR) | ~3 execuções/mês (~11 OR) |
O mito dos modelos chineses sempre mais baratos
Muita gente assume no automático que os modelos chineses são sempre a opção mais barata do mercado. Quando a gente coloca a economia real de tokens e prompt caching na ponta do lápis, a história fica bem diferente.
O DeepSeek V4.1 Flash realmente entregou um preço baixo (US$ 0,56 na tarifa oficial de pico, US$ 0,28 no off-peak e US$ 0,43 no OpenRouter). Só que olhe o volume de tokens que ele queimou para chegar lá: 32,35 milhões de tokens, quase sete vezes mais do que o GPT-6.1 Terra (4,67 milhões). Ele só saiu barato porque o desconto de leitura de cache da DeepSeek é brutal (98%, US$ 0,006 por milhão).
No DeepSeek V4 Pro, essa verbosidade explodiu ainda mais: foram 36,81 milhões de tokens, o maior volume do benchmark inteiro. Na API oficial deu US$ 3,39, mas se você rodar o mesmo modelo via OpenRouter a conta dispara para US$ 10,59, quase o dobro do Opus 5.5 e do GPT-6.2 Astra.
O caso mais curioso é o do GLM-5.3. Ele cravou a maior taxa de cache hit do benchmark inteiro (99,1%), mas gastou 20,80 milhões de tokens. Como a tarifa oficial de cache read da Z.ai é relativamente alta (US$ 0,26 por milhão), o GLM-5.3 custou US$ 6,08 na API oficial, saindo mais caro do que o Claude Opus 5.5 (US$ 5,73) e o GPT-6.2 Astra (US$ 5,78). Ele só vira pechincha quando você usa provedores com desconto no OpenRouter (onde a mesma rodada cai para US$ 1,58) ou a assinatura Coding Lite de US$ 18.
Já Qwen 4 Max (US$ 1,78, levando quase 44 minutos) e Kimi K3.1 Pro (US$ 2,66 oficial ou US$ 1,92 no OpenRouter, em 16 minutos) ficaram estacionados no meio da tabela junto com Sol, Sonnet e Hydrogen, bem acima dos US$ 0,15 do Luna e dos US$ 0,50 do Terra. Ou seja: a OpenAI, com Luna e Terra, hoje bate os modelos chineses em preço real de entrega.
A minha experiência prática com os chineses no dia a dia
Olhando para além da tabela do benchmark, no uso real do dia a dia a minha ordem de preferência entre os chineses é bem clara: primeiro GLM-5.3, depois Kimi K3.1 Pro, e só lá atrás o DeepSeek V4.1 Flash.
Na minha experiência prática, o DeepSeek é de longe o pior dessa turma. Eu só encosto nele quando as cotas de absolutamente todos os outros modelos já se esgotaram.
O motivo é simples: com o DeepSeek eu preciso ficar de babá o tempo inteiro. Às vezes ele se perde no meio do caminho e abandona a tarefa inacabada, entra em loops agentic estranhos ou simplesmente faz a coisa errada.
O DeepSeek é o único modelo desta geração atual que ainda se comporta mal desse jeito. Nenhum outro modelo que venho testando hoje em dia dá esse tipo de trabalho.
Escolha pelo seu problema, e faça seus próprios testes
Se existe uma lição que eu quero que fique deste artigo (e que já discuti quando falei sobre ser competente o suficiente), é que não existe um único modelo certo para todo mundo.
Você vai encontrar gente jurando de pés juntos que o GPT-6 Luna sozinho já resolve a vida inteira dela, e essa pessoa provavelmente tem razão, porque os problemas do domínio dela realmente não exigem mais do que o Luna entrega. Ao mesmo tempo, você vai encontrar engenheiros dizendo que não conseguem trabalhar com nada abaixo de um GPT-6.2 Astra ou Claude Opus 5.5, e eles também têm razão dentro da complexidade do domínio deles.
Cada equipe e cada codebase têm exigências diferentes. Nunca confie cegamente em nenhum benchmark, incluindo o meu. O Benchmark v5 olha especificamente para preço e velocidade numa app Rails feita do zero; isso coloca o Luna como o mais barato, e pronto. A resposta certa para a maioria das pessoas provavelmente está em algum ponto no meio da tabela.
No meu próprio fluxo de trabalho hoje, eu tenho usado muito mais Gemini 4 Neon do que Claude Opus 5.5 ou GPT-6.2 Sol. Raramente encosto no Claude Fable 5.2 ou no GPT-6.2 Astra, porque eles devoram a minha cota de tokens rápido demais sem me devolver um ganho proporcional. Na maior parte das tarefas, Opus e Sol já sobram com folga, e várias vezes eu sinto que até um Claude Sonnet 5.5 ou um GPT-6.1 Terra já dariam conta do recado perfeitamente.
Teste os modelos nos seus projetos reais, meça quanto tempo e quantos tokens cada um consome no seu tipo de código, e pare de pagar tarifa de foguete para fazer entrega de bicicleta.