Nas últimas semanas temos visto uma enxurrada de vulnerabilidades sendo expostas a torto e a direito com a ajuda de inteligência artificial. Eu já comentei sobre isso no artigo de provas formais e segurança cibernética com IA, quando projetos inteiros começaram a cair sob auditorias automatizadas.
Eu acho excelente que isso esteja acontecendo. A maioria esmagadora dessas falhas vinha de riscos conhecidos há décadas, que continuavam em produção porque os desenvolvedores assumiam que ninguém perderia tempo vasculhando aquele canto do código.
Com agentes de IA, explorar bugs triviais ficou barato demais. Aquela “segurança por obscuridade” que parecia proteger sistemas menores evaporou da noite pro dia.
Você precisa se preocupar com segurança desde o primeiro commit. O único jeito de desenvolver esse músculo é adotar uma postura de security first o tempo inteiro, colocando segurança até no seu hello world.
Um caso real: meu consolidador financeiro pessoal
Para mostrar como isso funciona na prática, vou usar como exemplo um aplicativo desktop de investimentos e acompanhamento bancário que construí para uso próprio. Eu mantenho o código no meu servidor Gitea privado aqui em casa e jamais vou abrir o código dele, por motivos óbvios.
Ainda assim, vale compartilhar a arquitetura de segurança que desenhei para ele. Encare este artigo como uma maneira de resolver o problema (entre várias possíveis), para servir de inspiração e ponto de partida para você estudar mais a fundo.
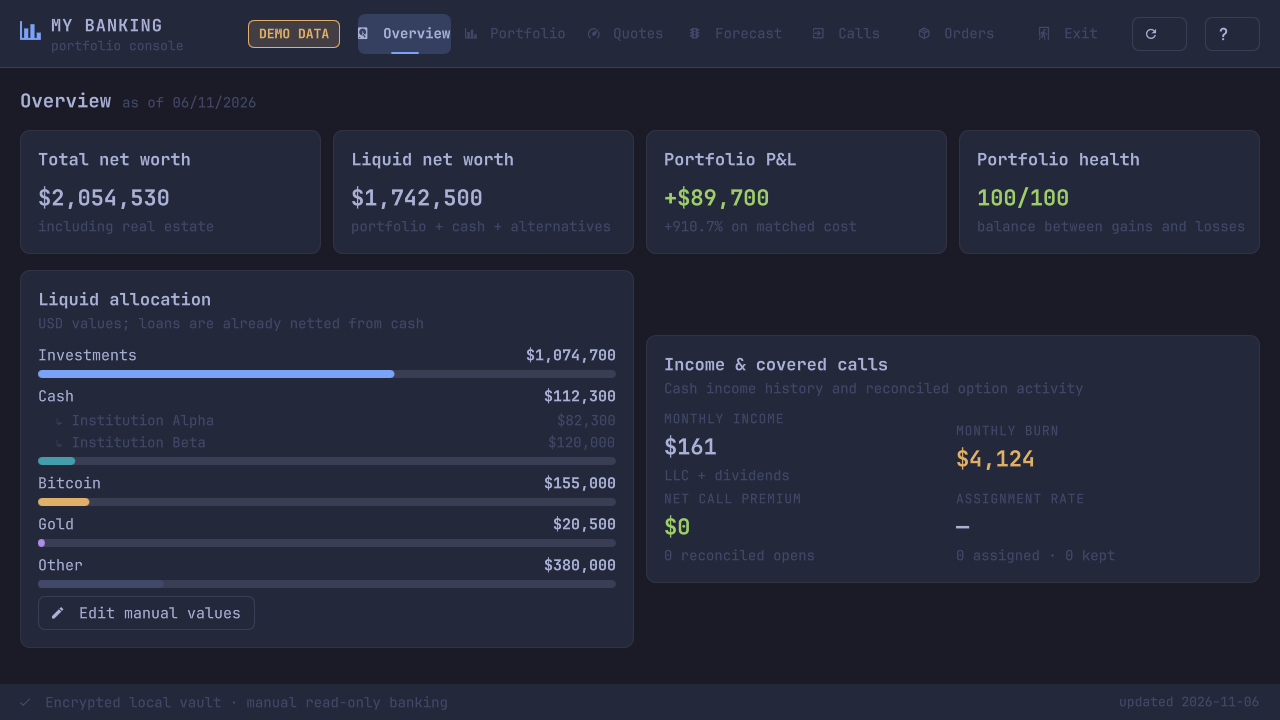
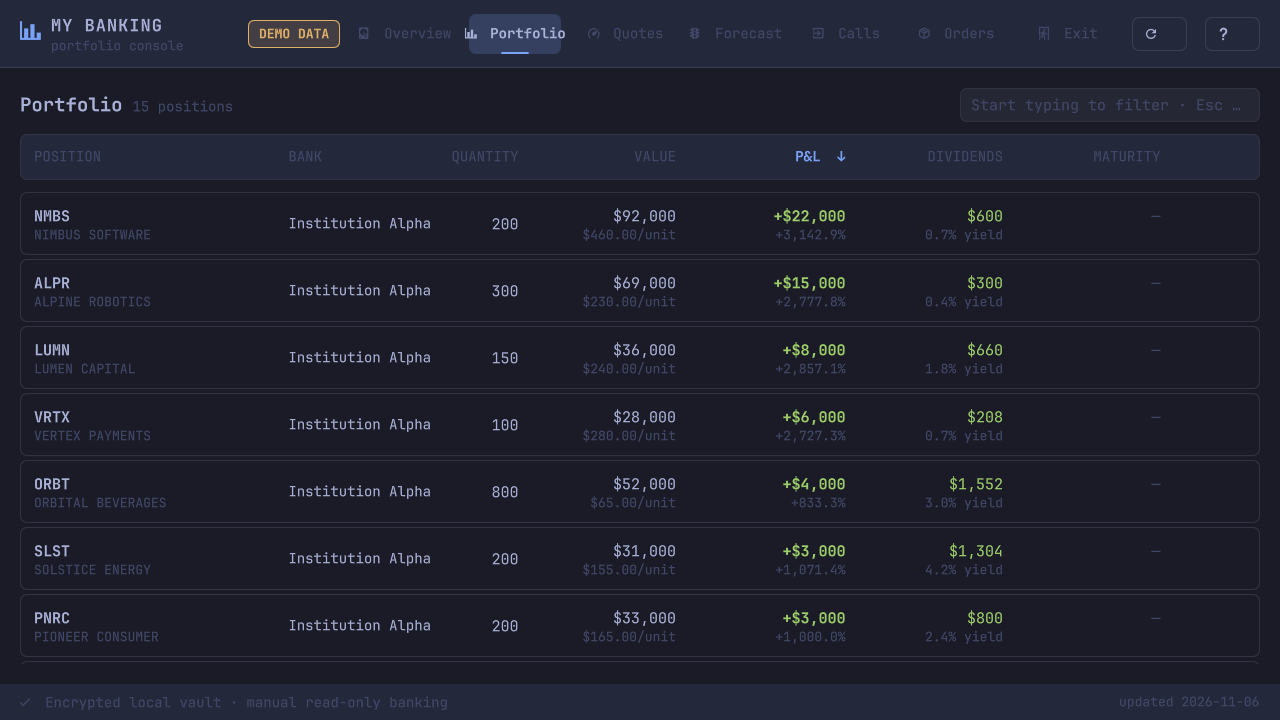
O aplicativo é uma GUI local escrita em Rust com interface em QtQuick/QML (usando Quickshell) e um banco de dados SQLite local. Ele consolida saldos, carteira de ações, vencimento de títulos de renda fixa, cálculo de covered calls e projeções de caixa (runway) em uma única tela. Vale avisar que absolutamente todos os números, saldos, instituições (Institution Alpha, Institution Beta) e tickers que aparecem nas capturas de tela acima e abaixo são dados 100% falsos, gerados pelo modo --demo do próprio aplicativo.
Por que o aplicativo precisa automatizar um navegador web em vez de bater numa API REST bonitinha? Porque a maioria dos portais de web banking e corretoras para pessoa física tem uma usabilidade terrível e zero API para clientes individuais.
Fazer isso na mão exigiria entrar em cada banco, consultar extratos por período, baixar planilhas Excel ou PDFs de notas de corretagem e copiar tudo para outro lugar. No meu fluxo atual, o app abre um navegador controlado, eu faço o login e o 2FA manualmente na página do banco, clico em um botão “Take over” e a automação assume apenas para ler os extratos, alimentar o banco de dados e encerrar a sessão.
O pecado original da versão experimental
Na primeira versão experimental (aquela que a gente faz no embalo do vibecoding só para ver os gráficos funcionando na tela), eu cortei todos os caminhos possíveis:
- O banco SQLite ficava aberto em texto puro no disco, com permissão
0644, legível por qualquer processo rodando com o meu usuário. - O navegador instrumentado salvava cookies e sessões em um perfil persistente no disco para acelerar o próximo acesso.
- As credenciais dos bancos ficavam guardadas no chaveiro da sessão (
secret-tool), permitindo que um timer dosystemdrodasse em background sem intervenção humana. - O Chromium subia com
--no-sandboxe abria a porta9333do Chrome DevTools Protocol (CDP) emlocalhostcom--remote-allow-origins=*. - Os códigos de verificação (OTP) eram lidos automaticamente da minha caixa de e-mail sincronizada localmente via
mbsync.
Eu costumo ser bem paranoico com segurança, e justamente por isso comecei a ficar ansioso sabendo que esses dados estavam dando sopa em texto puro no SSD. Mesmo sendo o meu PC pessoal, trancado no meu escritório, onde ninguém mais tem acesso físico, qualquer pacote malicioso de npm, extensão de navegador, script Python ou binário comprometido rodando com o meu UID teria acesso integral à minha vida financeira.
Se um único processo comprometido no seu usuário consegue fazer
catno seu banco de dados ou conectar na porta de debug do seu navegador logado no banco, você tem um problema grave de arquitetura.
Decidi parar tudo e reescrever a fundação de segurança do projeto como se fosse um sistema crítico de produção. Vamos passar por cada camada passo a passo, num nível que qualquer desenvolvedor júnior consiga acompanhar e reproduzir nos próprios projetos.
Passo 1: criptografando o SQLite com SQLCipher e migração verificada
O primeiro passo óbvio era tirar o banco SQLite do texto puro. No ecossistema SQLite, o padrão ouro para criptografia transparente de páginas é o SQLCipher (disponível em Rust via feature bundled-sqlcipher-vendored-openssl da crate rusqlite).
Em vez de apenas criptografar colunas soltas, o SQLCipher criptografa o arquivo inteiro página por página (usando AES-256 em modo CBC com autenticação HMAC-SHA512). Nem os nomes das tabelas, nem os índices e nem o cabeçalho padrão do arquivo (SQLite format 3\0) ficam visíveis no disco.
Para garantir que nenhuma conexão abra o banco com parâmetros fracos por engano, toda conexão passa por um inicializador que rejeita cabeçalhos em texto puro e aplica o perfil criptográfico antes de qualquer query:
const RAW_SQLITE_MAGIC: &[u8; 16] = b"SQLite format 3\0";
const CIPHER_PAGE_SIZE: u32 = 4096;
const CIPHER_KDF_ITER: u32 = 256_000;

fn apply_cipher_pragmas(conn: &Connection, key: &DatabaseKey) -> Result<()> {
    let key_pragma = format!("PRAGMA key = \"{}\";", key.sqlcipher_raw_key_literal());
    conn.execute_batch(&key_pragma)
        .map_err(|_| VaultError::InvalidKeyOrCorruptDatabase)?;

    conn.execute_batch(&format!(
        "
        PRAGMA cipher_compatibility = 4;
        PRAGMA cipher_page_size = {CIPHER_PAGE_SIZE};
        PRAGMA kdf_iter = {CIPHER_KDF_ITER};
        PRAGMA cipher_kdf_algorithm = PBKDF2_HMAC_SHA512;
        PRAGMA cipher_hmac_algorithm = HMAC_SHA512;
        PRAGMA cipher_plaintext_header_size = 0;
        PRAGMA cipher_memory_security = ON;
        PRAGMA foreign_keys = ON;
        PRAGMA secure_delete = ON;
        PRAGMA temp_store = MEMORY;
        PRAGMA trusted_schema = OFF;
        "
    ))?;

    let _: i64 = conn
        .query_row("SELECT count(*) FROM sqlite_schema;", [], |row| row.get(0))
        .map_err(|_| VaultError::InvalidKeyOrCorruptDatabase)?;

    Ok(())
}
Para quem está começando, vale entender o papel de cada PRAGMA ali em cima:
kdf_iter = 256000ePBKDF2_HMAC_SHA512fazem a derivação da chave passar por mais de 250 mil rodadas de hash SHA-512, tornando tentativas de força bruta muito lentas.cipher_plaintext_header_size = 0criptografa inclusive os primeiros bytes do arquivo (onde fica o salt de 16 bytes), de modo que ferramentas externas comofileouhexdumpenxergam apenas ruído aleatório.temp_store = MEMORYecipher_memory_security = ONimpedem que tabelas temporárias de ordenação vazem para/tmpem texto puro e limpam a memória alocada pelo SQLite antes de devolvê-la ao sistema operacional.trusted_schema = OFFevita que funções SQL ou triggers maliciosos embutidos num arquivo de banco de dados executem código inesperado.
Como migrar um banco existente sem perder dados
Quando você já tem meses de histórico financeiro num banco SQLite em texto puro, rodar um script de migração no susto é pedir para corromper dados. Eu implementei uma migração transacional com verificação matemática de integridade (logical fingerprint):
pub fn compute_logical_fingerprint(conn: &Connection) -> Result<String> {
    let mut hasher = Sha256::new();
    update_tagged(&mut hasher, "fingerprint-version", "1");

    let objects = load_schema_objects(conn)?;
    update_tagged(&mut hasher, "schema-object-count", &objects.len().to_string());
    for obj in &objects {
        update_tagged(&mut hasher, "schema-object-kind", &obj.kind);
        update_tagged(&mut hasher, "schema-object-name", &obj.name);
        update_tagged(&mut hasher, "schema-object-sql", &obj.sql);
    }

    for table in objects.iter().filter(|o| o.kind == "table") {
        hash_table_rows(conn, &table.name, &mut hasher)?;
    }

    Ok(hex_encode(&hasher.finalize()))
}
O processo completo de migração segue um roteiro estrito:
- Pausa qualquer timer antigo e executa
PRAGMA wal_checkpoint(TRUNCATE)para consolidar o arquivo WAL no banco principal. - Faz uma cópia de segurança com permissão
0600e calcula o hash SHA-256 lógico de todo o esquema e de todas as linhas ordenadas de todas as tabelas. - Usa
sqlcipher_exportpara copiar os dados para um novo banco criptografado, confere que o hash lógico permaneceu idêntico e importa também os PDFs de notas de corretagem que antes ficavam soltos em pastas de cache para dentro de uma tabeladocumentscriptografada. - Gera um pacote de backup
.mbbackup, restaura esse backup em um diretório temporário e recalcula o hash lógico pós-upgrade. - Só quando todos os hashes batem bit a bit, o sistema arquiva o banco antigo e move o banco criptografado para o caminho oficial usando a syscall
renameat2com a flagRENAME_NOREPLACE(que recusa sobrescrever qualquer backup existente por acidente).
Passo 2: onde guardar a chave? TPM 2.0, Polkit e queda de privilégios
Criptografar o banco de dados cria imediatamente o problema clássico de qualquer sistema de segurança: onde você guarda a chave que abre o banco?
Se você colocar a chave num arquivo .env ou config.json na sua pasta $HOME, você só trocou um cadeado aberto por um cadeado com a chave pendurada nele. Se você pedir para o usuário digitar uma senha toda vez e derivar a chave diretamente dessa senha, qualquer senha humana curta será o elo mais fraco; além disso, se a interface gráfica em QML ler essa senha, o processo da UI passa a ter acesso ao segredo.
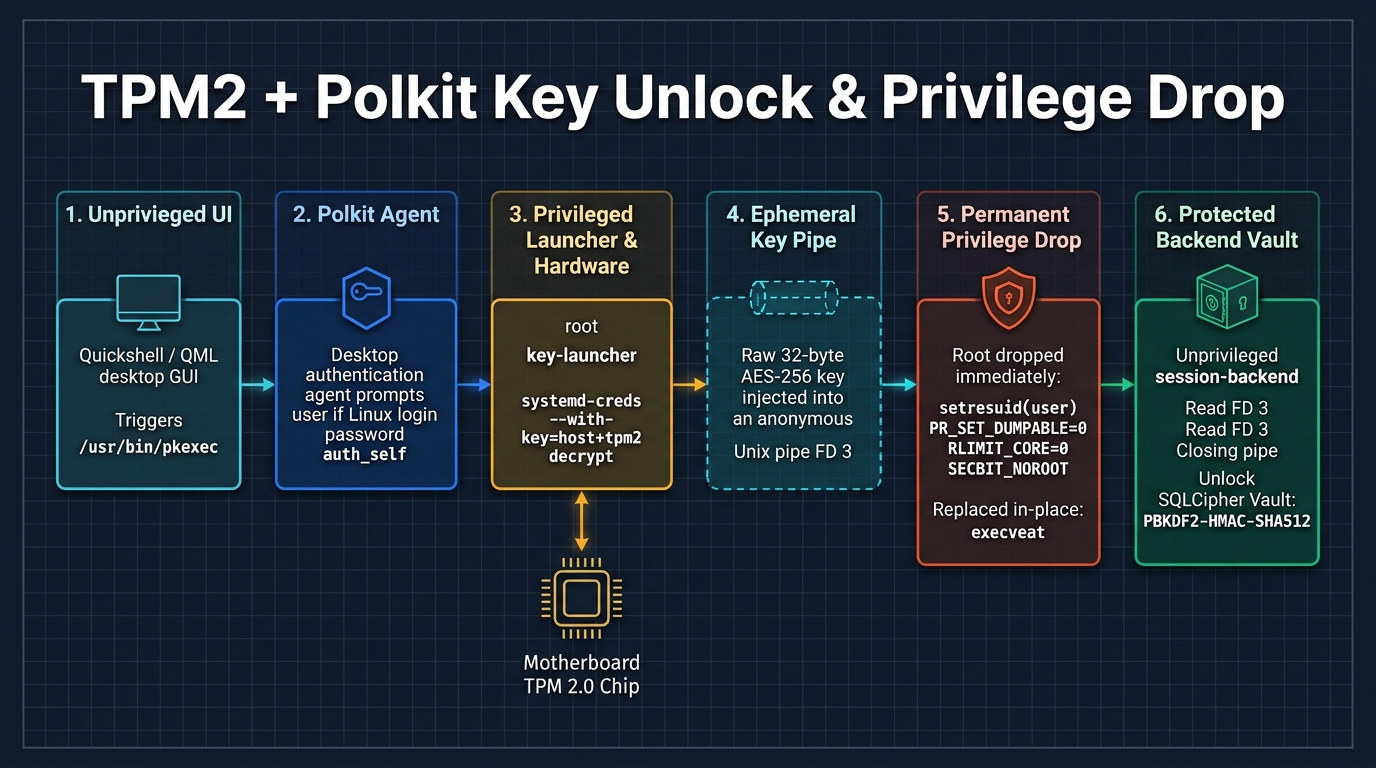
A solução que implementei combina três recursos nativos do Linux moderno: o TPM 2.0, o systemd-creds e o Polkit (pkexec).
O que é um TPM?
Para quem nunca mexeu com isso: TPM (Trusted Platform Module) é um pequeno chip criptográfico dedicado que já vem soldado na placa-mãe de praticamente qualquer PC ou notebook moderno (ou integrado no próprio processador, como Intel PTT e AMD fTPM).
Diferente de um arquivo no seu SSD, o TPM possui chaves internas gravadas em hardware que nunca saem de dentro do chip. Você pode entregar um bloco de bytes para o TPM (no nosso caso, uma chave aleatória de 256 bits gerada via CSPRNG do kernel) e pedir para ele “selar” (seal) esse segredo.
O TPM devolve um arquivo criptografado (.cred). Se um atacante roubar o seu SSD ou copiar esse arquivo .cred para outro computador, ele será inútil: apenas o chip TPM físico da sua placa-mãe consegue descriptografar aquele envelope.
No Linux com systemd, nós nem precisamos escrever código C cabeludo falando com /dev/tpmrm0 diretamente. O utilitário systemd-creds já faz o seal (encrypt com --with-key=host+tpm2) e o unseal (decrypt com --refuse-null, lendo o tipo de chave direto do cabeçalho do .cred):
pub fn build_systemd_creds_encrypt_command(cred_name: &str) -> (PathBuf, Vec<OsString>) {
    (
        PathBuf::from("/usr/bin/systemd-creds"),
        vec![
            OsString::from("--with-key=host+tpm2"),
            OsString::from("--name"),
            OsString::from(cred_name),
            OsString::from("--newline=no"),
            OsString::from("encrypt"),
            OsString::from("-"),
            OsString::from("-"),
        ],
    )
}

pub fn build_systemd_creds_decrypt_command(
    cred_name: &str,
    credential_path: &Path,
) -> (PathBuf, Vec<OsString>) {
    (
        PathBuf::from("/usr/bin/systemd-creds"),
        vec![
            OsString::from("--name"),
            OsString::from(cred_name),
            OsString::from("--newline=no"),
            OsString::from("--refuse-null"),
            OsString::from("decrypt"),
            credential_path.as_os_str().to_os_string(),
            OsString::from("-"),
        ],
    )
}
Como a minha senha de login destrava tudo sem tocar na UI
O arquivo .cred selado pelo TPM fica salvo em /var/lib/.../vault.key.cred, pertencente ao usuário root:root com permissão 0600. Nenhum processo rodando com o meu usuário comum consegue sequer ler esse arquivo.
Quando eu abro o aplicativo no desktop e clico em “Unlock Vault”, acontece uma coreografia bem específica:
- A interface gráfica dispara
/usr/bin/pkexec /usr/lib/.../key-launcher. - O Polkit intercepta a chamada e abre o prompt nativo do sistema operacional pedindo a minha senha de login do Linux (configurado com
<allow_active>auth_self</allow_active>, sem cache de sessão, exigindo autenticação a cada abertura). - A minha senha de login nunca passa pelo meu aplicativo. Quem valida a senha é o agente do Polkit/PAM do próprio sistema operacional.
- Assim que o Polkit confirma minha senha, ele inicia o binário
key-launchercomoroot. - O
key-launcherconfere que foi invocado pelo meu UID esperado (PKEXEC_UID), valida que os diretórios têm as permissões corretas sem symlinks maliciosos (usandoO_NOFOLLOW), e chama osystemd-credspara pedir ao TPM que abra o arquivo.cred. - O
key-launcherrecebe os 32 bytes da chave em memória (protegida comZeroizeOnDroppara ser zerada assim que sair de escopo), cria um pipe anônimo na memória do kernel, escreve os 32 bytes no File Descriptor 3 (FD 3) e fecha a ponta de escrita. - Antes de iniciar o backend do aplicativo, o
key-launcherjoga fora todos os privilégios de root de forma irreversível e substitui o próprio processo viaexecveat.
Olha como fica a sequência de queda de privilégios (privilege drop) e blindagem de memória em Rust dentro do key-launcher:
const KEY_FD: RawFd = 3;

fn drop_privileges_permanently(target_uid: u32, target_gid: u32) -> Result<()> {
    unsafe {
        libc::umask(0o077);
    }
    std::env::set_current_dir("/")?;

    drop_supplementary_groups()?;
    clear_capability_bounding_set()?;
    clear_ambient_capabilities()?;
    lock_no_root_securebits()?;

    // Troca GID e UID reais, efetivos e salvos de forma definitiva
    let rc_gid = unsafe { libc::setresgid(target_gid, target_gid, target_gid) };
    if rc_gid != 0 {
        return Err(LauncherError::Syscall("setresgid", io::Error::last_os_error()));
    }

    let rc_uid = unsafe { libc::setresuid(target_uid, target_uid, target_uid) };
    if rc_uid != 0 {
        return Err(LauncherError::Syscall("setresuid", io::Error::last_os_error()));
    }

    // Verifica que uma tentativa de recuperar root (setuid(0)) falha obrigatoriamente
    if unsafe { libc::setuid(0) } == 0 {
        return Err(LauncherError::PrivilegeVerification(
            "setuid(0) succeeded after privilege drop",
        ));
    }

    // Impede ganho de privilégios em execve futuros e bloqueia ptrace/core dumps
    unsafe {
        libc::prctl(libc::PR_SET_NO_NEW_PRIVS, 1, 0, 0, 0);
        libc::prctl(libc::PR_SET_DUMPABLE, 0, 0, 0, 0);
    }
    set_zero_core_limit()?;
    Ok(())
}
Repare nos detalhes no final dessa função:
PR_SET_DUMPABLE = 0eRLIMIT_CORE = 0proíbem o kernel de gerar arquivos de core dump no disco (que conteriam a chave do banco em memória) e impedem que outros processos do mesmo usuário anexem umgdbouptracepara inspecionar a RAM. Como o kernel Linux reseta o atributodumpablepara1após umexecveem binários normais, tanto osession-backendquanto os binários auxiliares do navegador e do parser reaplicamPR_SET_DUMPABLE = 0logo na primeira linha domain(enquantoRLIMIT_CORE = 0ePR_SET_NO_NEW_PRIVSjá vêm herdados do launcher).- Passar segredos por
--key=...ou variáveis de ambiente expõe o valor em/proc/<pid>/cmdlinee/proc/<pid>/environ. Passando via um pipe anônimo noFD 3que é lido uma única vez e fechado imediatamente no boot dosession-backend, o segredo jamais aparece no/proc. - A interface gráfica em QML conversa com o
session-backendapenas por mensagens JSON delimitadas por linha (NDJSON com limite de 64 KiB). A UI nunca recebe a chave criptográfica e nem toca no arquivo SQLite diretamente.
Blindando a chave na memória RAM (mlock, MADV_DONTDUMP) e auto-lock por inatividade
Mesmo depois que o session-backend lê os 32 bytes do FD 3 e fecha o descritor, a chave precisa viver na memória RAM enquanto o cofre estiver aberto. Isso levanta dois riscos clássicos que muita gente esquece: e se o kernel do Linux resolver paginar aquela região de memória para uma partição de swap não criptografada no SSD (ou imagem de hibernação)? E se eu destravar o aplicativo de manhã, minimizar a janela e esquecer o cofre aberto pelo resto do dia?
Para resolver o primeiro problema, o tipo DatabaseKey guarda os 32 bytes dentro de um Box<[u8; 32]> na heap e trava a página física na RAM com mlock:
pub struct DatabaseKey(Box<[u8; KEY_BYTES]>);

impl DatabaseKey {
    pub fn from_bytes(mut bytes: [u8; KEY_BYTES]) -> Self {
        let mut boxed = Box::new(bytes);
        bytes.zeroize();
        lock_key_page(&mut boxed[..]);
        Self(boxed)
    }
}

impl Drop for DatabaseKey {
    fn drop(&mut self) {
        let ptr = self.0[..].as_mut_ptr().cast::<core::ffi::c_void>();
        self.0.zeroize();
        let _ = unsafe { rustix::mm::munlock(ptr, KEY_BYTES) };
    }
}

fn lock_key_page(buffer: &mut [u8]) {
    let ptr = buffer.as_mut_ptr().cast::<core::ffi::c_void>();
    let len = buffer.len();
    unsafe {
        let _ = rustix::mm::mlock(ptr, len);
        #[cfg(target_os = "linux")]
        let _ = rustix::mm::madvise(ptr, len, rustix::mm::Advice::LinuxDontDump);
    }
}
Um detalhe sutil de Rust aqui: por que usar Box<[u8; 32]> em vez de um array inline [u8; 32] dentro da struct? Porque a syscall mlock(2) trava um intervalo de endereços virtuais específicos, e qualquer move de um array na stack mudaria o endereço dos bytes, deixando o endereço antigo travado à toa e o novo desprotegido.
Com Box, o endereço na heap permanece estável do nascimento até o Drop, onde limpamos os bytes com zeroize() antes de chamar munlock. De quebra, MADV_DONTDUMP marca aquela página específica para jamais entrar em um dump de memória.
Já para não deixar o cofre aberto indefinidamente quando esqueço a janela aberta em outro workspace, o loop principal do session-backend roda com um timer de inatividade (IDLE_LOCK_TIMEOUT de 15 minutos). Se passarem 15 minutos sem nenhuma requisição da UI e sem nenhuma coleta bancária em andamento, o backend fecha a conexão do SQLCipher, destrói a DatabaseKey (disparando o zeroize + munlock), avisa a UI que a sessão expirou (idle_locked) e encerra o próprio processo. Para voltar a usar o app, sou obrigado a passar novamente pelo prompt do Polkit e pelo TPM.
Passo 3: colocando o navegador e o parser de PDFs em uma prisão (sandbox)
Com o banco de dados trancado a sete chaves, sobrava a parte mais perigosa de qualquer aplicação moderna: o navegador web.
Um navegador é praticamente um sistema operacional inteiro executando JavaScript arbitrário vindo da internet. Na minha primeira versão, o navegador rodava solto na minha sessão com acesso à minha pasta $HOME, ao meu servidor gráfico principal e à internet inteira.
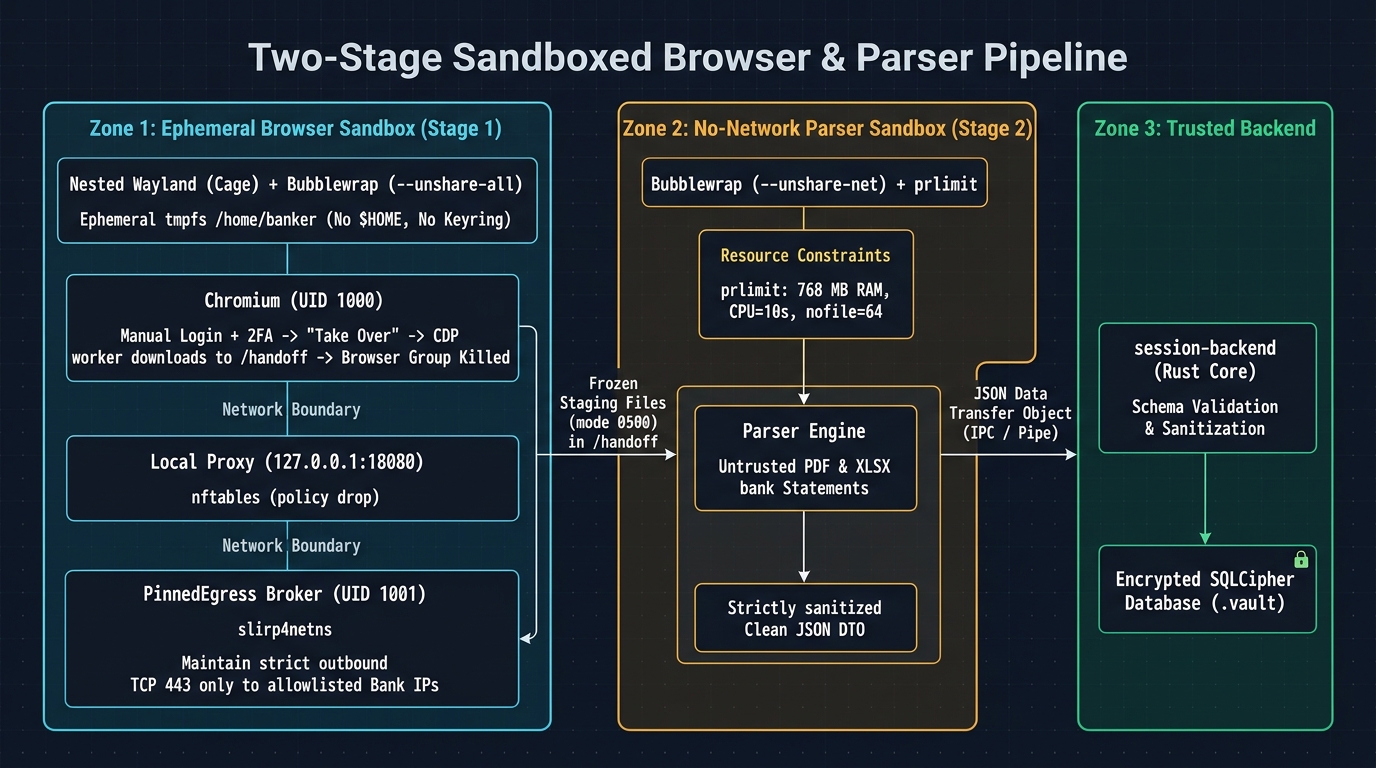
Para resolver isso, desenhei um pipeline em dois estágios isolados: um sandbox para o navegador durante o login manual, e um segundo sandbox sem rede apenas para fazer o parsing dos arquivos baixados.
Prós e contras de isolar o navegador em uma sandbox
Antes de ver o código, vale colocar na balança o que você ganha e o que você paga ao isolar o navegador dessa forma.
Do lado dos benefícios:
- O navegador enxerga apenas um
/home/bankersintético montado em RAM (tmpfs), sem qualquer acesso aos seus arquivos pessoais, chaves SSH (~/.ssh), GPG, carteira de cripto ou ao cofre SQLCipher. - Assim que a coleta termina e o processo morre, cookies, tokens de sessão, cache e localStorage desaparecem da memória RAM.
- Em vez de abrir a janela direto no compositor principal da sessão, rodamos dentro de um compositor Wayland dedicado (
cage), evitando que outras janelas façam keylogging ou captura de tela silenciosa. - Mesmo que um script malicioso tente enviar dados para um domínio externo, o firewall interno da sandbox bloqueia qualquer IP fora da lista do banco.
Do lado do custo operacional:
- Como o perfil começa do zero a cada execução e nenhuma credencial fica salva, eu preciso digitar meu login e aprovar o 2FA no celular toda vez que quero sincronizar os dados.
- Como trancamos os IPs de saída no início da sessão, se o banco usar um CDN que muda de IP no meio do login, a conexão cai e precisa ser reiniciada.
- O empacotamento exige ter
bubblewrap(bwrap),slirp4netns,nftablesecageinstalados e configurados no host.
Como funciona o bloqueio de rede dentro do Bubblewrap
Muita gente usa o bubblewrap (bwrap) com slirp4netns --disable-host-loopback achando que isso basta para isolar a rede. Essa flag realmente impede que o navegador acesse serviços rodando no 127.0.0.1 da máquina host, mas continua permitindo que o navegador conecte em qualquer IP público da internet.
Para impedir que o navegador converse com qualquer servidor fora do banco que estou acessando, o sandbox cria dois usuários diferentes dentro do namespace de rede: o navegador roda como UID 1000 (BROWSER_UID) e um pequeno proxy Rust interno (Pinned Egress Broker) roda como UID 1001 (BROKER_UID).
Antes do navegador abrir, um conjunto de regras nftables com política padrão drop é aplicado dentro do namespace:
pub fn generate_nftables_ruleset(
    pinned: &PinnedEgress,
    broker_port: u16,
    browser_uid: u32,
    broker_uid: u32,
) -> Result<String> {
    let mut allowed_ips = Vec::new();
    for addrs in pinned.host_addrs.values() {
        for addr in addrs {
            if !is_globally_routable_bank_ip(*addr) {
                return Err(SessionError::PinnedIpNotPublic(*addr));
            }
            if !allowed_ips.contains(addr) {
                allowed_ips.push(*addr);
            }
        }
    }

    let ip_list = allowed_ips
        .iter()
        .map(Ipv4Addr::to_string)
        .collect::<Vec<_>>()
        .join(", ");

    Ok(format!(
        "table inet bank_sandbox {{\n\
         \tchain output {{\n\
         \t\ttype filter hook output priority 0; policy drop;\n\
         \t\tct state established,related accept\n\
         \t\toifname \"lo\" meta skuid {browser_uid} ip daddr 127.0.0.1 tcp dport {broker_port} accept\n\
         \t\toifname \"lo\" meta skuid {broker_uid} ip daddr 127.0.0.1 accept\n\
         \t\tmeta skuid {broker_uid} ip daddr {{ {ip_list} }} tcp dport 443 accept\n\
         \t\tdrop\n\
         \t}}\n\
         }}\n"
    ))
}
Olha que elegante o efeito dessas cinco linhas de nftables:
- O navegador (
skuid 1000) é proibido de sair para a internet diretamente (policy drop). O único pacote que o kernel deixa o navegador enviar é para127.0.0.1:18080, onde mora o nosso broker. - O broker (
skuid 1001) recebe o pedidoHTTP CONNECT host:443, confere se ohostestá na lista estrita daquele banco (ex.:ebanking.bank-alpha.example), e conecta diretamente nos endereços IPv4 públicos que foram pré-resolvidos antes do navegador nascer. - IPs privados (RFC 1918), loopback, link-local e endpoints de metadados (
169.254.169.254) são rejeitados na hora, anulando ataques de DNS rebinding. - Como o Chromium roda dentro do
bwrapcom um namespace de usuário mapeado adequadamente, nós mantemos o sandbox interno do próprio Chromium ligado (sem--no-sandbox), e o CDP escuta em uma porta efêmera (--remote-debugging-port=0) acessível apenas dentro do namespace isolado.
Ponte de área de transferência unidirecional e de uso único (--paste-once --sensitive)
Isolar o navegador em um compositor Wayland próprio (cage) com um diretório XDG_RUNTIME_DIR separado cria um problema prático imediato: como eu colo uma senha aleatória de 30 caracteres vinda do meu gerenciador de senhas do desktop para dentro do navegador isolado?
Se você compartilhar o socket Wayland principal só para fazer o Ctrl+V funcionar, você joga fora todo o isolamento gráfico e permite que uma página maliciosa leia ou sobrescreva a sua área de transferência do host.
A solução foi construir uma ponte de clipboard estritamente unidirecional (do host para o cage) usando wl-paste e wl-copy:
fn nested_clipboard_offer_command(wl_copy: &Path, runtime: &Path, nested_display: &str) -> Command {
    let mut command = Command::new(wl_copy);
    command
        .args([
            "--foreground",
            "--paste-once",
            "--trim-newline",
            "--type",
            "text/plain;charset=utf-8",
            "--sensitive",
        ])
        .env_clear()
        .env("PATH", "/usr/bin")
        .env("XDG_RUNTIME_DIR", runtime)
        .env("WAYLAND_DISPLAY", nested_display)
        .stdout(Stdio::null())
        .stderr(Stdio::inherit());
    command
}
Funciona assim: o processo supervisor fora do bwrap observa apenas texto puro copiado no host e o injeta no socket Wayland aninhado (wayland-bank) com as flags --paste-once e --sensitive.
O navegador dentro do sandbox consegue receber um único Ctrl+V da senha que acabei de copiar no gerenciador de senhas; imediatamente após essa colagem, o wl-copy destrói a oferta dentro do sandbox e encerra. E como não existe ponte no sentido inverso, o navegador jamais consegue escrever nada de volta na área de transferência do meu desktop.
O segundo estágio: fazendo parsing de PDFs e Excel sem rede
Depois que eu faço o login no banco, clico em “Take over” e o worker baixa os extratos ou notas de corretagem para a pasta /handoff, o supervisor mata imediatamente todo o grupo de processos do navegador e da rede.
Só que agora temos outro risco: fazer parsing de arquivos PDF e planilhas XLSX vindos de fora. Bibliotecas que leem PDF e formatos legados de Excel são historicamente cheias de vulnerabilidades de memória e denial of service (inclusive atualizamos a crate calamine durante o projeto por conta do advisory RUSTSEC-2026-0436).
Em vez de deixar o processo principal que tem a chave do banco abrir esses PDFs, o sistema congela o diretório de staging com permissão 0500 (somente leitura) e dispara um segundo sandbox bwrap, dessa vez com --unshare-net (zero interface de rede) e limites rígidos de recursos via prlimit:
const PARSER_AS_LIMIT_BYTES: u64 = 768 * 1024 * 1024; // 768 MiB RAM max
const PARSER_CPU_LIMIT_SECONDS: u64 = 10;             // 10s CPU max
const PARSER_NOFILE_LIMIT: u64 = 64;                  // max 64 file descriptors
const PARSER_NPROC_LIMIT: u64 = 16;                   // max 16 threads/processes

pub fn build_sandboxed_parser_command(
    bwrap_program: &Path,
    prlimit_program: &Path,
    parser_binary: &Path,
    staging_dir: &Path,
    output_file: &Path,
    bank: &str,
) -> (PathBuf, Vec<OsString>) {
    // ...
    let args = vec![
        OsString::from("--unshare-all"),
        OsString::from("--unshare-net"),
        OsString::from("--die-with-parent"),
        OsString::from("--new-session"),
        OsString::from("--clearenv"),
        // Monta /usr, /lib e o diretório de staging em modo somente-leitura (--ro-bind)
        // ...
    ];
    // Executa sob prlimit --as=768M --cpu=10 --nofile=64 --nproc=16 --core=0
}
Se um PDF malformado tentar explodir a memória (um zip bomb dentro de um XLSX) ou explorar um bug no parser, o processo bate no teto de cerca de 770 MB de RAM ou 10 segundos de CPU, fica sem rede para exfiltrar nada, sem acesso ao banco de dados e acaba morto pelo kernel. O processo principal só aceita o resultado se o parser devolver um JSON estritamente tipado e validado dentro do limite de tamanho.
Passo 4: backups autenticados, chave de recuperação e NAS
Quando você trava seu banco de dados no chip TPM da placa-mãe, surge uma pergunta inevitável: e se a minha placa-mãe queimar amanhã?
Se o único jeito de abrir o banco fosse o chip TPM daquela placa-mãe específica, um defeito de hardware significaria perder todos os seus dados financeiros para sempre. Segurança sem plano de recuperação de desastres é só uma forma sofisticada de perder dados.
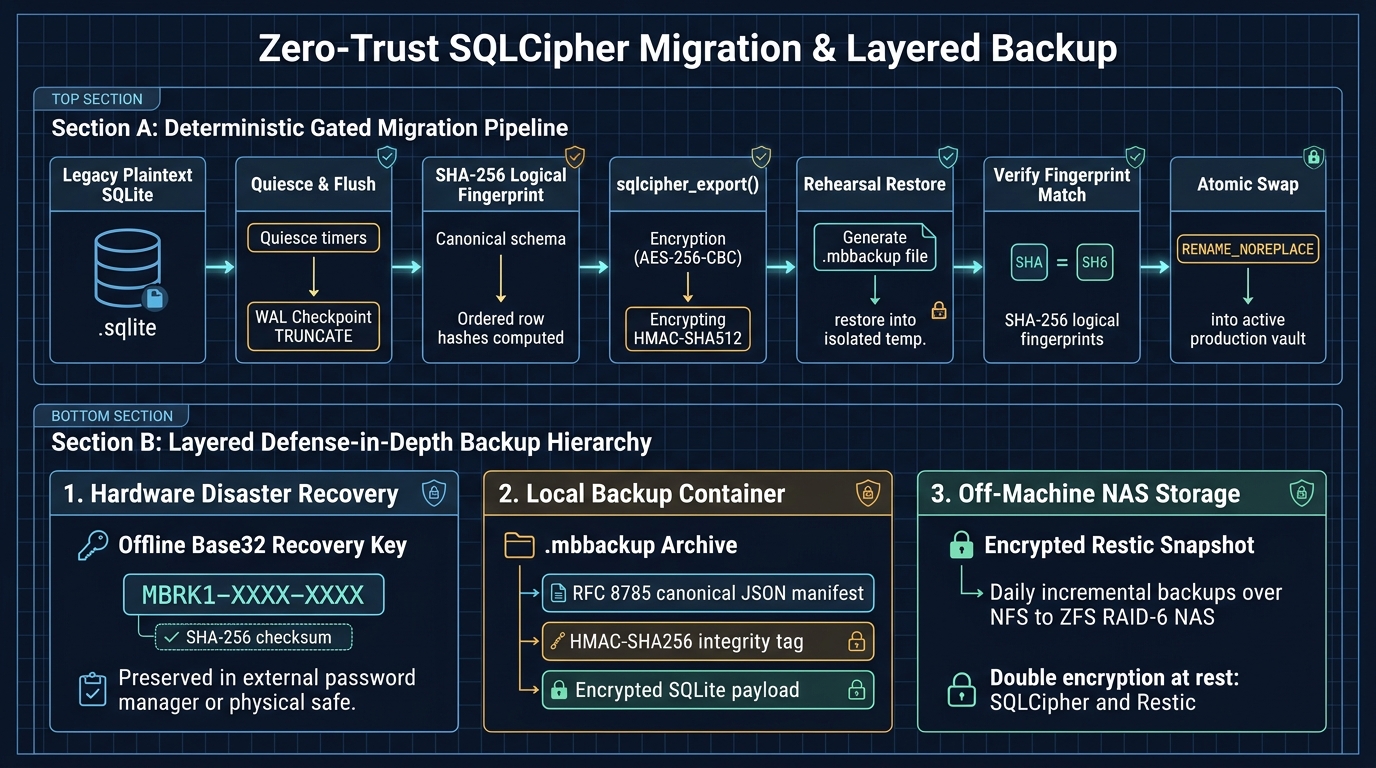
Por isso, a estratégia de backup e recuperação foi dividida em três camadas.
1. Código de recuperação offline com checksum
No momento em que o cofre é criado (enrollment), o key-launcher gera a chave de 256 bits e, antes de selá-la no TPM, exibe uma única vez no terminal (/dev/tty) um código de recuperação codificado em Base32 no formato MBRK1-XXXX-XXXX-..., protegido por um checksum SHA-256 de 5 bytes contra erros de digitação.
O programa exige que você redigite esse código às cegas no terminal para provar que você realmente o anotou (eu guardo o meu em uma nota segura no meu gerenciador de senhas, fora da máquina) antes de permitir que o cofre seja ativado. Se meu PC pegar fogo, basta rodar o utilitário de restauração do pacote em uma máquina nova, informar o código MBRK1-... e o sistema restaura o cofre e re-sela a chave no TPM do computador novo.
2. Pacotes .mbbackup autenticados com teste de restauração imediato
Copiar um arquivo SQLite com cp enquanto ele está aberto pode gerar um backup corrompido. Por isso o app possui um formato próprio de backup (.mbbackup) que empacota:
- Um cabeçalho mágico (
MBBACKUP) + versão do formato; - Um manifesto em JSON canônico (seguindo a RFC 8785) contendo a versão do schema, parâmetros do SQLCipher, quantidade de documentos embutidos e o logical fingerprint SHA-256 de todos os dados;
- O payload binário do banco já criptografado pelo SQLCipher;
- Uma assinatura
HMAC-SHA256de 32 bytes calculada sobre o cabeçalho, o manifesto e o payload, usando uma subchave derivada viaHKDF-SHA256.
O detalhe mais importante: toda vez que um backup é criado, a própria função de backup abre imediatamente o arquivo .mbbackup recém-gerado, restaura em um diretório temporário, valida o HMAC e compara o fingerprint lógico antes de retornar sucesso. Backup que nunca foi testado na restauração não existe.
3. Backup externo diário no NAS com dupla criptografia
Por fim, manter o backup apenas no mesmo SSD onde mora o banco original deixa você exposto a falha de disco ou ransomware.
Aqui em casa eu mantenho meus servidores NAS em RAID-6 (incluindo o QNAP com ZFS RAID-Z2 para onde evacuei meus dados recentemente depois que quase perdi 90 TB de dados quando dois discos do meu antigo Synology falharam juntos durante um rebuild, e o próprio Synology reconstruído em RAID-6). Toda madrugada, às 3h da manhã, um timer do systemd na minha estação de trabalho roda o Restic fazendo snapshot incremental da minha pasta de projetos e dados via NFS para o NAS, mantendo uma rotação enxuta de snapshots diários, semanais e mensais (3 diários, 3 semanais e 2 mensais).
Repare na defesa em profundidade aqui: mesmo que alguém invada a rede local, comprometa o servidor NFS ou roube fisicamente os HDs de dentro do NAS, o atacante encontrará um repositório Restic criptografado; e mesmo que por algum milagre ele tivesse a senha do Restic, o arquivo dentro do backup já é um cofre SQLCipher criptografado cuja chave mora dentro do TPM da minha estação de trabalho.
Conclusão: segurança como gestão de risco contínua
Quão seguro tudo isso deixa o meu aplicativo? Ele é seguro o suficiente para o meu modelo de ameaça, sabendo que segurança absoluta simplesmente inexiste no mundo real.
No próprio documento de arquitetura do projeto (ADR 0001), eu deixei registrado explicitamente os riscos residuais que escolhi aceitar:
- Eu mantenho o Secure Boot desabilitado na minha estação por conta do meu fluxo de boot e drivers no Linux; logo, o selo do TPM protege contra roubo de disco e processos desprivilegiados, enquanto ataques físicos ao bootloader antes do sistema subir ficam fora desse escopo.
- O compositor Wayland aninhado (
cage) isola o navegador emwayland-bank, mas o própriocageainda é um cliente do compositor principal da sessão (Hyprland/wlroots). Um processo malicioso rodando com o meu UID no host ainda poderia usar protocolos de captura de tela do compositor (zwlr_screencopy_v1/ext_image_copy_capture_v1, como ogrim) enquanto a janela do banco está visível, ou ler a senha no clipboard do host antes de ela ser limpa após o Ctrl+V. - O
key-launchergarante em tempo de execução (viaO_NOFOLLOW) que os binários instalados em/usr/lib/...pertencem aroot:root, impedindo que um processo do meu usuário troque o executável instalado. Porém, como eu desenvolvo o projeto na mesma máquina com o meu UID normal, um malware no meu usuário poderia tentar alterar o código-fonte ou scripts de build (cargo/makepkg) esperando a próxima vez que eu compilar e instalar um pacote atualizado compacman -U, o que exige revisargit statuse o diff antes de empacotar. - Apagar o banco antigo em texto puro em um SSD moderno com sistema de arquivos Copy-on-Write (como Btrfs) desvincula o arquivo do sistema operacional, mas o wear leveling da controladora flash física pode reter blocos antigos até serem sobrescritos.
- Enquanto o cofre está aberto e desbloqueado na minha sessão, um malware que já tenha conseguido execução de código como
rootno meu kernel ativo pode fazer o que quiser.
É aqui que a maioria das pessoas se engana. Muita gente trata segurança como se fosse um interruptor binário: ou o sistema é “seguro” ou é “inseguro”.
Na vida real, segurança é um jogo contínuo de avaliação de risco: “quanto você está disposto a proteger, e a que custo de preço, tempo e usabilidade?”.
O único computador “perfeitamente seguro” é aquele desligado da tomada, sem placa de rede, trancado dentro de um bloco de concreto no fundo do oceano (e ele também não serve para nada).
Se o seu aplicativo precisa se conectar ao site do seu banco pela internet para buscar um extrato, ele já deixou de ser perfeitamente isolado por definição. A partir daí, o nosso trabalho como engenheiros é empilhar mitigações em camadas (criptografia em repouso, chave selada em hardware, queda de privilégios, isolamento de namespaces, firewall por UID, parser sem rede, backups verificados) e entender exatamente quanto risco residual ainda sobra em cada camada.
A inteligência artificial é fantástica para escanear vulnerabilidades conhecidas e até para implementar essas blindagens quando você sabe exatamente o que pedir para ela. Mas a IA jamais vai adivinhar o seu modelo de ameaça sozinha, e muito menos vai salvar você da própria ignorância.
Se você apenas pedir para o agente criar um app no vibecoding e aceitar tudo de olhos fechados, confiando 100% na IA sem entender como funcionam permissões do Linux, processos, memória, rede e criptografia, o seu aplicativo nascerá inseguro por padrão. Estude os fundamentos, desconfie do caminho mais fácil e coloque segurança desde o seu primeiro hello world.