Parem de inventar desculpas e façam mais deploy! Com a IA, a premissa mudou. Entendam.
Hoje eu soltei uma sequência de posts no X batendo nessa tecla e, como sempre que eu falo de deploy rápido, um bocado de gente leu “esse cara está dizendo pra subir qualquer porcaria em produção sem testar”. Não é isso. Deixa eu explicar com calma, porque o argumento é mais estreito e mais chato do que a versão que espalha pânico.
É melhor deployar mais rápido, porque corrigir depois ficou rápido e barato.
Essa frase é o artigo inteiro resumido. O resto é só eu justificando por que ela é verdade agora, mesmo não sendo verdade há alguns anos, e mostrando como eu mesmo ajo em cima dela desde fevereiro.
A premissa mudou, e a maioria não percebeu
Comecei a falar isso no X assim:
Corrigir ficou barato. Não segurem coisas mais. Só sobe e corrige depois. “Ain mas corro o risco de subir com bug”. A premissa errada é achar que vc ficar olhando linha a linha vai fazer qualquer diferença num volume grande. E código parado não melhora sozinho. Só código usado dá pra descobrir se precisa melhorar.
E completei no segundo post, porque a primeira leitura de qualquer coisa que eu escrevo em 280 caracteres sempre vem raivosa e literal demais:
Entendam o conceito (é post de X, não de blog, parem de ler literalmente). Não estou dizendo que IA não gera bugs. Gera, óbvio. Mas a esta altura do campeonato, não mais do que você/humano gera também. […] Antigamente a desculpa era que quando sobe em produção com bug, ele fica lá mais tempo do que deveria, porque nunca vira prioridade na sprint pra resolver. Agora NÃO TEM MAIS ISSO, a premissa mudou: corrigir o bug depois é RÁPIDO e BARATO.
Esse é o ponto inteiro. Não é sobre IA ser infalível. É sobre o custo de corrigir um erro ter despencado, e a maioria dos times ainda estar operando o processo de revisão como se esse custo continuasse alto.
Com os modelos de fronteira de hoje, Opus, Sol, K3, e companhia, o LLM erra menos do que a maioria dos desenvolvedores humanos que eu já vi passar por um code review. Quando erra, na esmagadora maioria das vezes o erro não é do modelo. É de quem dirigiu o harness. O LLM faz o que você pede, e não faz o que você não pediu.
Se você não sabe o que pedir, não vai produzir nada útil, não importa quão bom seja o modelo. É exatamente por isso que só Engenheiro de Software de verdade consegue tirar software de produção de verdade de um agente: alguém tem que saber decompor o problema, validar o resultado, e reconhecer quando o pedido em si estava mal formulado. IA não substitui esse julgamento. Ela multiplica o que esse julgamento já sabia fazer.
Isso já era pra ser assim há 25 anos
O incômodo que eu sinto com o processo de review burocrático não é novo, e a indústria já devia ter resolvido isso há muito tempo. Kent Beck e Ron Jeffries inventaram Extreme Programming em 1997, no projeto Chrysler C3, e Beck publicou o livro em 1999 com integração contínua, TDD e entrega em lotes pequenos como práticas centrais. Em fevereiro de 2001, dezessete desenvolvedores se trancaram num resort em Snowbird, Utah, e saíram de lá com o Manifesto Ágil. Isso faz vinte e cinco anos.
O mantra de Martin Fowler pra integração contínua sempre foi “se dói, faça com mais frequência”, e o livro Continuous Delivery, de Jez Humble e Dave Farley, formalizou a ideia de que deploy pequeno e frequente reduz risco, não aumenta. Os relatórios anuais de State of DevOps da DORA documentam isso com número desde a década passada:
- time de elite: deploya sob demanda, várias vezes por dia;
- time de baixa performance: deploya uma vez por mês, às vezes uma vez a cada seis meses.
E o achado mais chato de engolir pra quem tem medo de deployar rápido: historicamente, deploy mais frequente não aumenta a taxa de falha. Reduz. Time que deploya mais, na média dos relatórios da última década, falha menos e recupera mais rápido quando falha.
Mesmo com tudo isso documentado, medido e publicado há mais de uma década, boa parte da indústria continua represando mudança em lote grande, com revisão manual demorada, e chamando isso de “prudência”. Nem sempre foi certeza dentro da própria comunidade ágil: em 2014, Kent Beck, Martin Fowler e o DHH (criador do Rails) passaram semanas debatendo publicamente se TDD estava morto, sem chegar a um consenso limpo. Ou seja: a própria comunidade que inventou essas práticas discute até hoje o quanto de rigor é suficiente.
O que eu estou dizendo é mais simples que essa discussão inteira: seja qual for o seu nível de rigor de teste, o LLM revisando seu diff antes do merge é rápido, e reverter um deploy ruim ficou trivial com container e git. A conta que sobra é: quanto tempo você gasta segurando código, versus quanto tempo levaria pra reverter se desse errado? Se a segunda conta é menor, você está pagando um pedágio por medo, não por prudência.
Não é “suba qualquer coisa”
Essa é a parte que sempre se perde: eu não estou dizendo pra deployar sem nenhuma prática de engenharia por baixo. Estou dizendo o oposto. Isso só é seguro depois que você já tem a engenharia de software básica funcionando, o que eu documento à exaustão neste blog há anos: teste automatizado, CI que roda em todo push, capacidade real de reverter, observabilidade pra saber quando algo quebrou.
80/20. Peça pra LLM fazer uma revisão mínima e sobe. Se quebrar, reverte (pra isso temos containers, git, etc etc). Se não dá pra reverter, sua infra é uma bosta - corrija ela pra ontem.
Essa última frase é o filtro inteiro. Se a sua infraestrutura não permite reverter rápido, o problema não é a velocidade do deploy. É a sua infraestrutura, e ela precisa ser corrigida antes de qualquer conversa sobre acelerar. Ninguém está liberado pra pular a etapa de ter rollback de verdade. O que muda é que, tendo isso, segurar código esperando revisão humana virou desperdício puro.
O ambiente mínimo recomendado
Eu já falei “engenharia de software básica” várias vezes neste texto sem detalhar o que isso significa na prática. Aqui está a lista, sem enrolação. Nenhum item aqui é opcional, e nenhum deles ficou caro de manter:
- teste unitário cobrindo a lógica isolada, TDD ou não, contanto que exista;
- teste de cenário e integração cobrindo concorrência, falha parcial e conflito, o que teste unitário sozinho não pega;
- CI que builda e testa em toda mudança, de preferência pras plataformas que você realmente publica;
- revisão automática hostil antes do merge, tipo
pr-audit, que trata alegação do contribuidor como não verificada até prova; - feature flag pra controlar o raio de explosão de quem vê a mudança primeiro;
- staging de verdade como gate antes de qualquer usuário real ver a mudança;
- capacidade de reverter rápido, com git e container, e observabilidade pra saber quando algo quebrou;
- em ambiente de compliance, financeiro ou de saúde, uma camada extra: teste de cenário mais pesado, e mais de uma trava por modo de falha identificado.
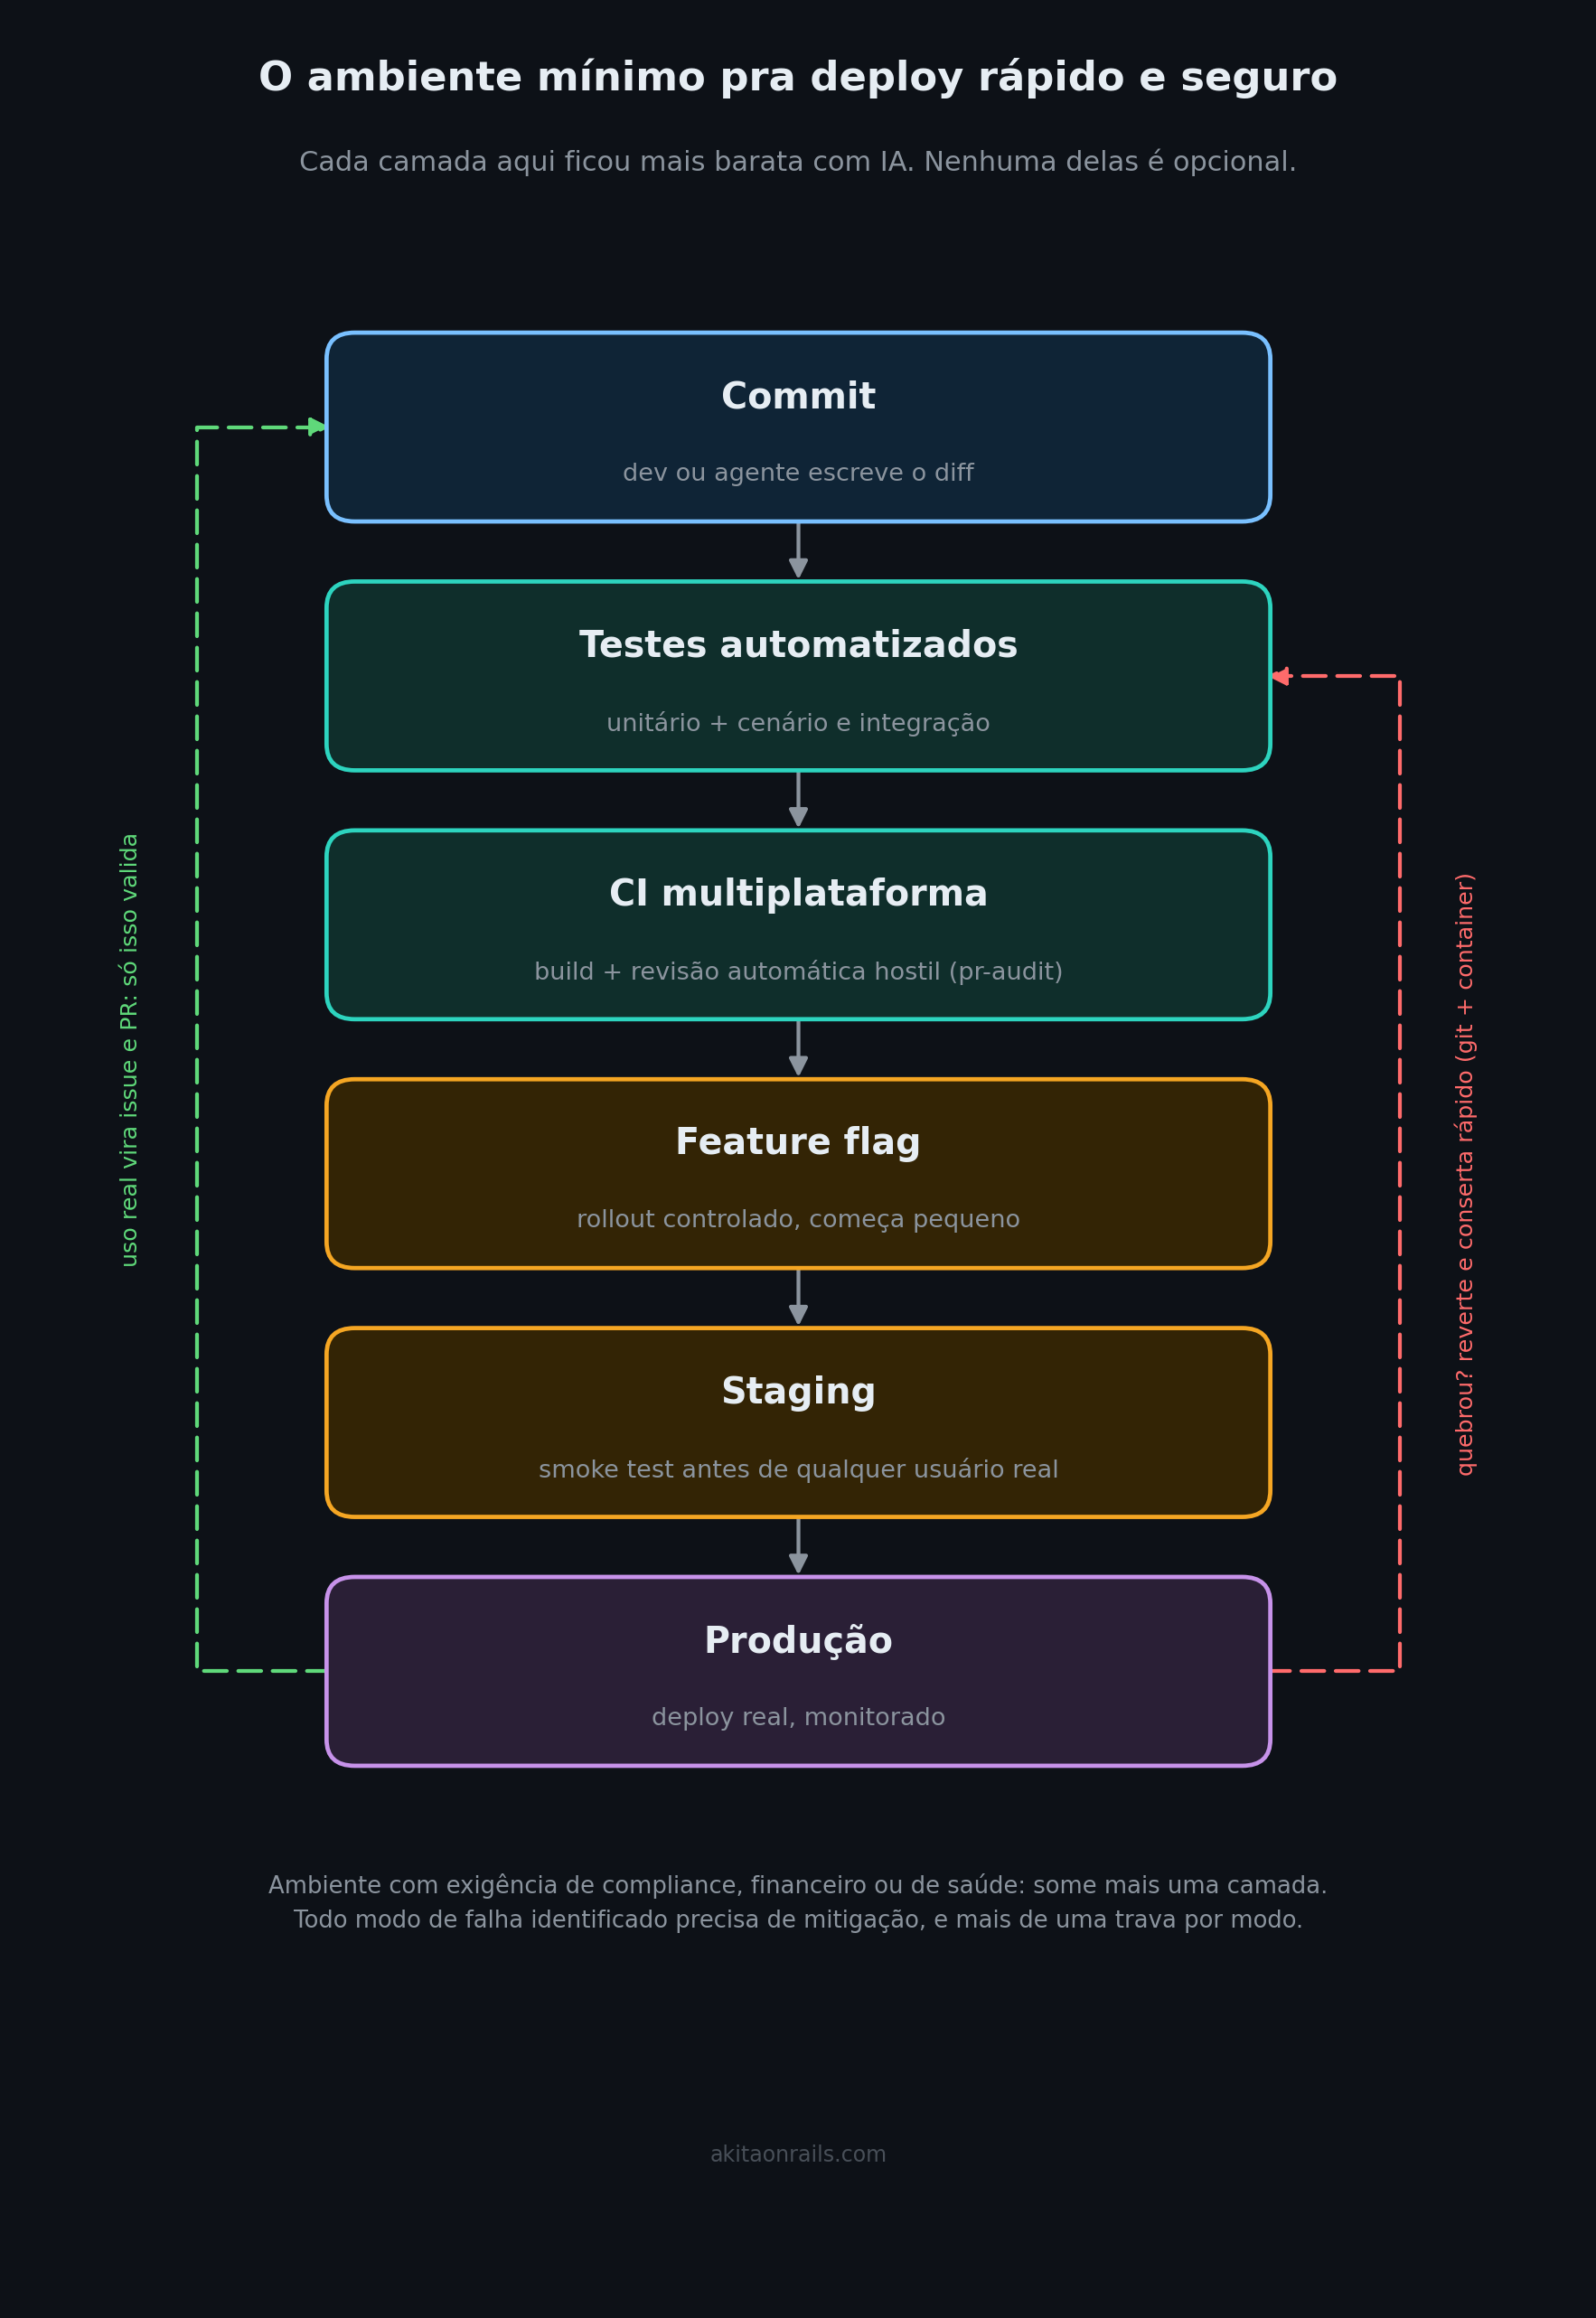
O que o diagrama tenta deixar claro é que velocidade e segurança não competem entre si aqui. Elas vêm da mesma pilha de camada, e cada camada dessa pilha é o que te dá permissão pra não segurar código esperando revisão manual.
Onde essa conta não fecha
Não vou fingir que não veio crítica boa nas respostas do X, porque várias batem num ponto real que eu pulei ao escrever rápido pra Twitter. Vale mais responder de verdade do que só validar quem concordou.
Reverter código não desfaz consequência que já saiu do seu sistema. Se o bug já processou um pagamento errado, moveu dinheiro pra conta errada, ou controlou um elevador, reverter o deploy não desfaz o que já aconteceu. “Se não dá pra reverter, sua infra é uma bosta” cobre a parte técnica de deploy e rollback, não o caso onde o dano já saiu do seu sistema antes de você conseguir reagir. Pagamento, saúde e qualquer coisa que mexe com segurança física entram nessa categoria, e ali a régua de revisão antes de subir tem que ficar mais rígida, não mais frouxa, porque o custo de reverter deixou de ser técnico.
Banco de dados quebra a analogia de “reverter é fácil”. Reverter um binário é trivial. Reverter uma migration que já rodou em produção, já moveu dado, e talvez já apagou coluna, não é. Existe um padrão pra isso, expand-contract: adiciona o novo formato sem remover o velho, espera todo consumidor migrar, só depois remove o velho. Isso não é sobre confiar mais ou menos em IA. É sobre estado que não se desfaz com
git revert.Biblioteca e pacote público não seguem a mesma conta que aplicação fechada. Quando o meu código quebra, eu conserto na hora. Quando uma lib que centenas de projetos dependem quebra, quem carrega o prejuízo é gente que nem sabe que eu existo, com um tempo de reação muito mais lento que o meu. É por isso que a minha skill de
pr-audit, que eu descrevo mais abaixo, trata classificação de semver como gate de versão: breaking change anda em major, nunca em patch, porque ali a revisão de verdade não é sobre pegar bug, é sobre não surpreender quem depende de você sem avisar.Loja de app derruba a velocidade também, e o meu próprio exemplo do frank_yomik esconde isso em vez de resolver. Ele publica o APK direto como GitHub Release, sem passar pela Play Store. Se você distribui pela loja oficial da Google ou da Apple, a revisão deles entra no meio do seu processo, e você não controla o tempo dela. Este artigo é sobre remover o gargalo que está dentro do seu controle. A loja de app não está dentro dele.
O ponto mais honesto de todos: toda evidência que eu trago aqui vem de projeto onde eu sou o único dono e decido sozinho. Não tenho como provar, com meus próprios números, que o mesmo ritmo funciona dentro de uma empresa grande, com Jurídico, Compliance e gerente de produto no meio do caminho. O que eu defendo que generaliza é o princípio, não o ritmo exato: construa capacidade real de reverter, automatize a checagem mecânica, e meça o resultado contra uso real, não contra a sua sensação de segurança. Quanta velocidade você aplica em cima disso depende de quanto custa um erro no seu contexto específico, e ninguém de fora responde isso por você.
Sobre o primeiro ponto especificamente, vale abrir mais, porque “régua mais rígida” não pode ficar vago. Isso significa teste de cenário real, não só teste unitário. O próprio ai-memory tem mais de mil testes de integração espalhados pelos seus módulos, e a maioria não pergunta “essa função devolve o valor certo?”. Pergunta coisa como:
- o que acontece quando duas escritas concorrem pelo mesmo arquivo ao mesmo tempo;
- o que acontece quando o disco falha no meio de uma operação de exclusão;
- o que acontece quando duas sessões tentam consolidar o mesmo dado ao mesmo tempo;
- o que acontece quando o processo morre antes de terminar de escrever.
Ambiente com exigência de compliance, financeiro ou de saúde, precisa desse nível de teste: todo modo de falha identificado tem que ter mitigação, e mais de uma camada de checagem, nunca uma trava só.
E aqui está o ponto que sustenta o argumento inteiro deste artigo mesmo nesses ambientes: essa exigência não muda dependendo de quem escreveu o código. Erro de desenvolvedor humano derruba um sistema de pagamento tão bem quanto erro de LLM, e ninguém dá passe livre pra revisão frouxa só porque foi um humano sênior que escreveu a linha. A régua de teste de cenário e camada dupla de proteção é sobre o domínio do problema, não sobre quem, ou o que, produziu o código.
Feature flag e ambiente de staging são a outra metade dessa camada dupla, e eles também mudaram de custo. Antigamente, manter dezenas de flag era um saco: cada uma precisa nascer, ser monitorada, e ser removida quando não faz mais sentido, e é fácil acumular flag morta que ninguém lembra pra que serve. Isso ficou barato também: peço pro agente auditar todo flag do projeto, achar qual está travada no mesmo valor há meses, e gerar o PR de limpeza. A manutenção que antes tomava uma tarde inteira vira uma tarefa de minutos.
Com isso resolvido, a defesa em camada fica simples de montar: staging pra pegar erro óbvio antes de qualquer usuário ver, feature flag pra limitar o raio de explosão de quem vê a mudança primeiro, e teste de cenário pra cobrir o que staging sozinho não simula. Três camadas, nenhuma delas cara de manter.
Como eu faço isso desde fevereiro
Comecei a acelerar minha produção com IA em fevereiro deste ano, e a pergunta que eu queria responder era simples: dá pra usar a nova geração de LLMs de fronteira pra programar o tempo inteiro, num ritmo de produção de verdade, não só demo? A resposta virou meu maior benchmark de LLMs, mais de 110 artigos publicados desde então, e isto, como eu escrevi recentemente:
Desde fevereiro produzi mais de 110 artigos no meu blog. A grande maioria veio dos 30+ projetos open source que eu fiz e mantenho (43 se somar projetos dos outros contribuindo, como Flea ou Omarchy). 1.6 milhão de linhas de código produzidos. Eu sozinho (com agentes, claro).
Os projetos que eu mais uso no meu próprio dia a dia, e que sobreviveram ao teste de “eu continuo mantendo isso meses depois”, são três:
- ai-jail: sandbox de SO pros meus agentes de código;
- ai-memory: memória de longo prazo pros agentes;
- ai-usagebar: widget de barra pra monitorar consumo de LLM.
Dois deles já têm landing page decente:
O ai-jail subiu hoje. O ai-memory está no ar em aimemorybr.netlify.app porque a transferência do domínio aimemory.io ainda vai levar mais alguns dias.
As duas rodam no Netlify. Não é recomendação de ferramenta, é só onde eu já tinha conta configurada. O ponto que importa aqui não é a plataforma, é o fluxo: pra colocar uma versão nova no ar, o comando é git push. Não existe passo manual entre o commit e o site atualizado.
A minha newsletter, The M.Akita Chronicles, já passa de 15 mil assinantes:
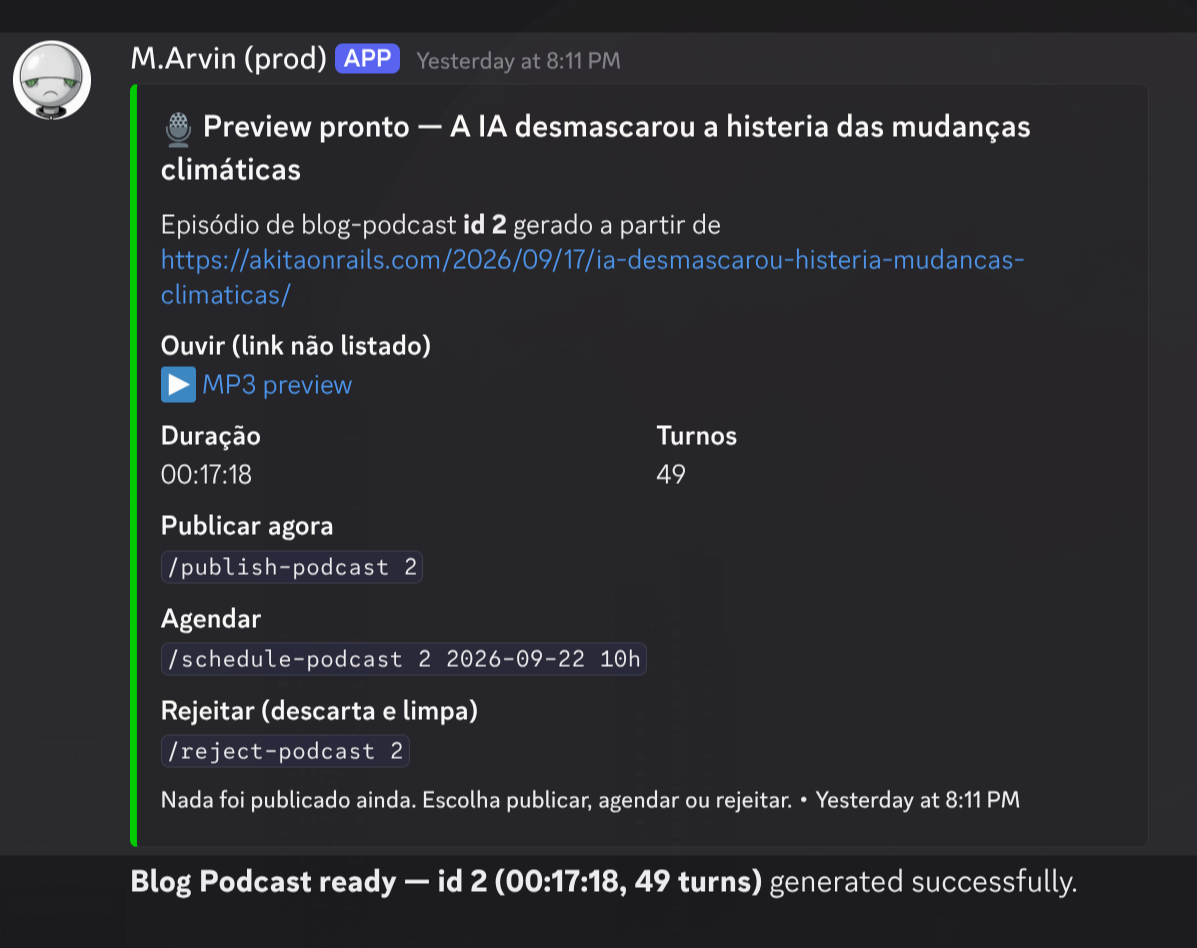
E o esforço mais novo é converter os posts do blog em episódio de podcast. Isso roda inteiro dentro do Discord, com um bot que gera o preview e espera meu comando:
Um /publish-podcast 2 depois, o episódio está publicado e a transcrição já tem URL:
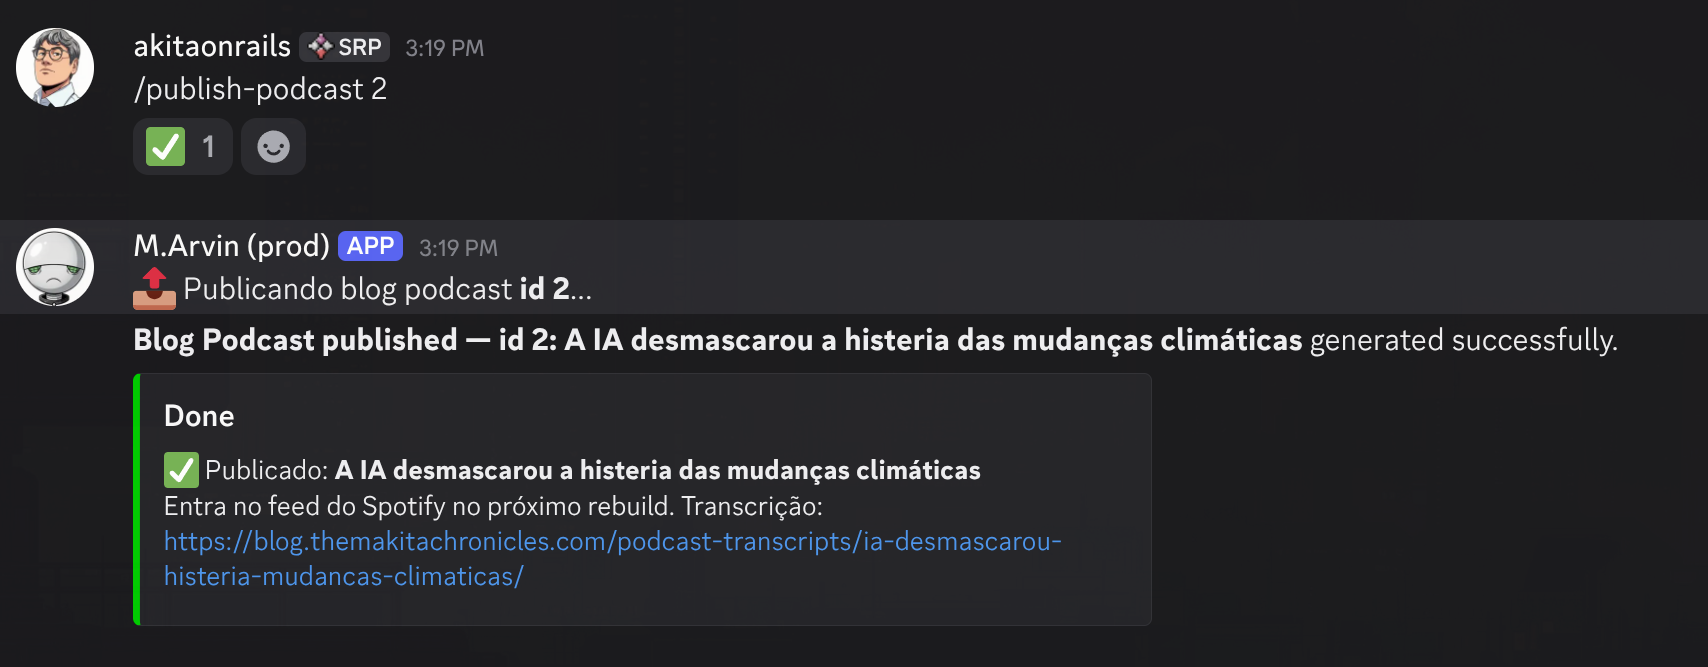
Do texto pronto até o áudio publicado, o processo inteiro é eu digitando um comando de barra numa conversa de Discord. Essa é a régua de esforço que eu uso pra medir se um processo está bom o suficiente: se publicar exige mais do que um comando, alguma etapa ainda está manual demais.
CI/CD multiplataforma sem esforço
Fui contar quantos dos meus projetos ai-* e frank-* (18 repositórios no total, entre os que têm README) já têm build e deploy automatizado. Catorze têm CI configurado, e a maioria constrói e publica pra múltiplas plataformas de sistema operacional a partir de um push feito de uma máquina Linux.
O exemplo mais completo é o próprio ai-memory: um único push de tag dispara um workflow que, na mesma execução:
- builda Linux x86_64 e arm64;
- builda macOS arm64 e x86_64;
- builda Windows x86_64, com empacotamento em PowerShell;
- publica uma imagem Docker multi-arquitetura;
- empurra o pacote pro AUR do Arch Linux.
O ai-usagebar segue o mesmo padrão de build pra Linux e Windows, e ainda publica em dois pacotes do AUR, no crates.io, e num bucket do Scoop pra Windows.
E tem o caso do frank_yomik, meu leitor de mangá com OCR e tradução via LLM local, que é o exemplo que eu queria pra mostrar que Android entra na mesma esteira. Um push de tag v* dispara cinco builds em paralelo:
- Linux;
- macOS;
- Windows;
- extensão de navegador;
- Android, num runner Linux comum, decodificando um keystore de assinatura guardado nos secrets do GitHub e gerando o APK já assinado.
No final, um job espera os cinco terminarem e publica um único GitHub Release com todos os binários juntos. Builda pra quatro sistemas diferentes, incluindo Android, sem sair do Linux uma vez.
Nem tudo saiu perfeito na primeira olhada, e eu prefiro admitir isso a fingir que é tudo redondo: o frank_sherlock e o frank_karaoke publicam a release como rascunho por padrão, o que trava a automação seguinte (como o push pro AUR) até alguém clicar em “publicar” manualmente. Achei esse buraco enquanto escrevia este texto.
Um projeto vizinho, o frank_scanlation, já tinha resolvido um problema parecido, mas diferente: o GitHub suprime o evento que dispara automação quando a própria release foi criada pelo token do robô, então o workflow dele dispara a etapa seguinte na mão, via workflow_dispatch, de dentro do próprio job. Nenhum dos dois ajustes é difícil. Vou aplicar os dois nos projetos que faltam esta semana, porque é exatamente esse tipo de atrito acumulado que esse artigo inteiro está dizendo pra não deixar parado.
E já que estamos falando de atrito escondido: o ai-memory tem código específico pra Windows (índice de arquivo NTFS, hook nativo em PowerShell) que só roda de verdade no runner windows-latest do GitHub, uns 1000 segundos contra 250 no Linux pra mesma suíte. Cheguei a montar uma VM Windows local via dockur/windows achando que ia ganhar velocidade.
Não ganhei: o workload é dominado por E/S de disco, e o resultado saiu mais lento que o runner do GitHub pra suíte inteira. Ficou útil só pra iteração rápida num crate isolado. Ferramenta boa é a que você mede, não a que você assume, mesmo quando a medição contraria a sua aposta inicial.
A revisão automática que sustenta tudo isso
Eu já detalhei minhas skills de revisão num artigo recente, então vou resumir aqui:
pr-auditaudita todo PR antes do merge com o princípio de evidence over narrative: nada do que o contribuidor escreveu é verdade até prova, com checklist hostil pra código malicioso, credencial exposta, quebra de semver e tentativa de prompt injection;iss-auditaplica a mesma desconfiança pra issue, nunca executando comando colado por quem reportou;github-resolutiontransforma o que foi aprovado em código mergeado, um ticket de cada vez, com teste de regressão escrito antes da correção, e a regra de que “slop é defeito”: sem abstração especulativa, sem TODO esquecido, sem enfraquecer teste pra passar mais rápido.
Isso pega a categoria mais cara de porcaria dentro do mesmo diff. Não pega duplicação espalhada entre PRs diferentes, porque a auditoria olha um diff isolado, não a arquitetura inteira do projeto. Essa parte ainda depende de eu notar o padrão se repetindo e mandar consolidar.
Na minha estimativa, isso resolve uns 99% do trabalho de revisão e resolução sozinho, comigo supervisionando e decidindo os casos que sobram. Só que isso não é o ponto principal. Automação de revisão é necessária, mas ela sozinha não prova nada sobre se o software é bom.
O que realmente mantém isso no chão: gente de verdade usando
Aqui está a parte que eu acho mais importante do artigo inteiro, e que costuma passar batido: a sua própria revisão não vale tanto quanto você acha. O que vale é software publicado sendo usado por gente de verdade, dando feedback de verdade.
Fui checar os números reais do ai-memory no GitHub, sem arredondar pra impressionar:
- issues: 287 no total, 249 vieram de gente que não sou eu, 86,8% do total;
- pull requests: 562 no total, 371 de fora, sendo 10 delas bump automático do Dependabot e as outras 361 vindas de gente de verdade, cerca de 121 contribuidores distintos.
Os dois que mais contribuíram junto comigo mandaram 64 e 43 PRs cada, sozinhos.
Isso é o que mantém o projeto no chão. Não é o LLM sendo bom revisor, nem eu sendo bom revisor. É centenas de pessoas usando de verdade, achando casos que eu nunca imaginei, e mandando issues e PRs reais. Sem isso, minhas skills de revisão automatizada estariam apenas confirmando as minhas próprias suposições de volta pra mim, por mais rigorosas que as regras pareçam no papel.
Não importa o quão boa é a IA que você usa: se ninguém usa o que você publicou, você não tem feedback real, e sem feedback real não existe melhoria real. Só existe a sua própria opinião sobre o próprio trabalho, validada por ninguém além de você mesmo.
A conclusão que interessa
Engenharia de software de verdade precisa ter deploy rápido e de esforço quase zero. Não é opcional, não é luxo de time grande, é pré-requisito. E se revisar e colocar em produção está demorando mais tempo do que desenvolver a funcionalidade, você não está só errado.
Você é o gargalo.
Desculpa e justificativa não valem nada nesse momento. Use esse tempo pra consertar você mesmo e o seu processo, porque só resultado no mundo real importa, não a sensação de segurança de ter revisado linha por linha um diff que ninguém mais vai olhar de novo.
Se a premissa mudou, eu mudo hoje. Não amanhã, não semana que vem. E se a sua ainda não mudou, o problema não é a IA. É você segurando o próprio trabalho.